E‑CommerceBench:通义千问开源的长周期电商智能体仿真评测基准
一、E‑CommerceBench是什么
E‑CommerceBench是通义千问QwenLM团队开源的长周期自主商业Agent评测基准,基于脱敏真实电商交易数据构建完整仿真经营环境,专门用来检验大模型智能体完成完整电商商家经营全流程的综合能力。
基准设定AI智能体扮演电商商家,初始本金10万元,最多开设4家网店,模拟连续365天完整商业周期。模型需要自主完成供应商谈判、采购备货、库存管控、商品定价、订单履约、售后退货等全部经营动作,最终以年末总资产作为核心结果,同时配套多维度细分指标衡量谈判、风控、工具调用、长期记忆等能力,解决传统问答式评测无法检验大模型长期闭环决策能力的痛点。项目开源仓库基于Apache‑2.0协议开放,附带完整仿真环境、数据集、运行脚本与评估可视化工具,同时配套arXiv学术论文支撑实验结论。
二、功能特色
完整365天长时序仿真:非单点问答任务,模拟一整年真实电商经营,包含季节波动、大促活动、市场突发冲击事件,考验模型长期规划与动态调整能力,会触发大模型上下文溢出问题。
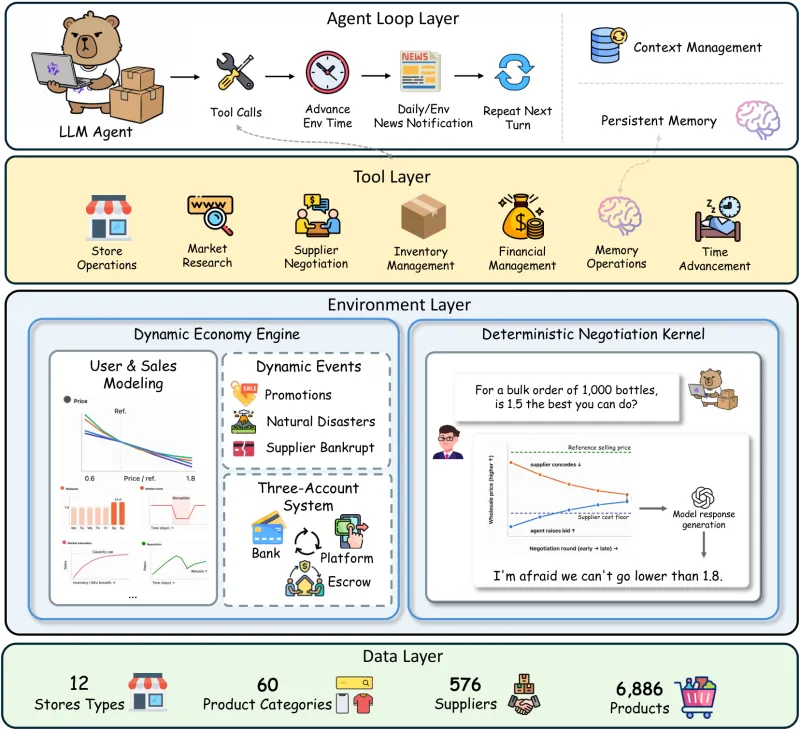
真实脱敏电商数据集:内置6886件商品、60个商品类目、576家供应商;其中包含152家欺诈供应商,设置5种诈骗模式,无法仅依靠价格信息识别骗局,测试Agent风控识别能力。
多轮自然语言议价NPC内核:供应商拥有独立议价逻辑与底价,大模型只能输出对话交互,不能绕过底层商业规则,还原现实采购谈判博弈场景,资金结算设置9天托管延迟,模拟真实现金流账期压力。
多维综合评测指标体系:不只看最终资产收益,提供资产乘数、议价能力CSE⁺、欺诈资金占比BadSpend%、资产最大回撤、工具调用收益、议价复购系数等多维度指标,避免单一指标带来的评价偏差。
内置上下文管理模块:原生提供token感知上下文裁剪组件,专门解决长周期运行下上下文窗口溢出问题,测试Agent记忆筛选、信息沉淀能力。
完整实验工具链:支持冒烟小测试、完整年度仿真、多轮重复实验,自动保存每日资产、全部对话交互日志,自带日志解析、资产曲线绘图、指标统计脚本,兼容主流闭源与开源大模型API接入。
三、技术细节
项目代码目录结构
agent/     智能体主循环、大模型客户端、系统提示词
context_manager/ 上下文感知裁剪,处理长周期token溢出
tools/     18项电商业务工具集合,供Agent调用
opponent/    供应商谈判内核、欺诈逻辑、经济规则计算
data/      商品、供应商、促销事件原始脱敏数据集
evaluation/   日志解析、指标计算、结果可视化绘图脚本
docs/      模型接入配置文档
核心运行机制
仿真环境为确定性环境,市场、供应商底价、事件全部固定,多次运行变量仅来自大模型输出,保障实验可复现。
NPC供应商对话由独立模型负责生成对话文本,但不会修改底层经济决策参数,底价、让步幅度由opponent模块固定控制。
评测实验默认每个模型运行5次完整365天仿真,取各项指标平均值消除模型输出随机性干扰。
支持主流模型:OpenAI、Anthropic、Dashscope通义千问、智谱、月之暗面、DeepSeek等API,通过
models_config.json配置模型参数。环境约束:资金托管9天延迟;不允许篡改底层环境参数;支持限制最大运行天数做快速冒烟验证。
核心评测指标说明
| 指标 | 释义 |
|---|---|
| 资产乘数 | 年末总资产÷初始10万本金,主收益指标 |
| CSE⁺ | 诚实交易议价争取空间占比,衡量谈判能力 |
| BadSpend% | 采购资金流向欺诈供应商占比,风控能力 |
| Drawdown/peak | 资产最大回撤,衡量现金流抗风险水平 |
| ¥ per tool call | 单次工具调用产生的收益,工具使用效率 |
| AnchorRatio | 复购订单溢价系数,衡量模型议价学习能力 |
四、应用场景
大模型Agent能力测评:评估不同大模型在长周期闭环商业任务的综合表现,不只看问答跑分,检验规划、记忆、风险识别、工具调用真实落地水平。
Agent算法研发调试:用于开发、迭代长记忆Agent、上下文压缩、智能体规划策略,观察模型在连续数百天任务中的错误模式与行为缺陷。
学术科研实验:电商智能体、长时序大模型、AI决策方向学术实验,可直接复用数据集、仿真环境,产出可复现对比实验结果。
垂类商业智能原型验证:用来测试电商AI商家助手、自主采购Agent原型,在模拟环境低成本验证策略,避免线上真实业务试错成本。
教学与案例研究:理解AI智能体的短板,观察大模型在现金流管理、防欺诈、长期记忆上的典型失败案例。
五、使用方法
环境依赖安装
pip install -r requirements.txt
API密钥配置:填写对应大模型服务商API Key,修改
models_config.json配置待测试模型参数。快速冒烟小测试(缩短周期,用于调试)
python run.py --model xxx --max‑days 10 --max‑turns 50
完整365天全年仿真实验
python run.py --model xxx
多次重复实验(官方标准5轮测试)
python run.py --model xxx --runs 5
结果评估分析:运行evaluation目录脚本读取输出日志,输出各项评测指标,生成资产变化可视化曲线,导出完整交互记录。
也可以使用项目内置run.sh脚本,自动完成日志时间戳归档、实时绘图。
六、竞品对比
选取AgentBench、RealReplicaBench作为对标基准,对比维度、任务形态、任务周期、核心目标、任务特点:
| 对比项 | E‑CommerceBench | AgentBench | RealReplicaBench |
|---|---|---|---|
| 开发团队 | QwenLM通义千问团队 | 北大、清华等联合 | 阿里国际站Accio Work团队 |
| 任务类型 | 连续365天电商商家全周期经营仿真 | 多领域离散式智能体任务集 | 电商离散业务任务集 |
| 时间周期 | 长时序连续仿真,状态持续累计 | 单轮独立任务,任务之间状态隔离 | 单任务独立执行,无连续经营状态 |
| 核心目标 | 评估长周期闭环商业决策、记忆、现金流风控能力 | 通用多领域Agent综合能力测评 | 电商单点业务任务通过率测评 |
| 数据来源 | 脱敏真实电商商品、供应商、市场事件数据集 | 公开多领域测试用例 | 真实电商业务场景任务用例 |
| 评测重点 | 资产收益、谈判博弈、防欺诈、上下文长记忆 | 工具调用、单任务完成成功率 | 采购、上架、订单处理等任务通过率 |
| 输出结果 | 资产曲线、多维度经营指标,完整经营日志 | 各任务成功率、完成度得分 | 任务通过/失败统计、通过率榜单 |
七、常见问题解答
Q:E‑CommerceBench是否可以用来做线上真实电商业务?
A:不可以,它是仿真评测基准,仅用于离线实验测评,环境是模拟虚拟电商世界,无法对接真实店铺、真实供应商和真实订单业务,所有资金、商品均为虚拟数据。
Q:运行完整365天仿真的成本高吗?
A:完整一年仿真会产生大量token消耗,完整5轮全量实验API调用成本较高,开发调试优先使用--max‑days参数运行短周期冒烟测试,验证逻辑无误再跑完整年度实验。
Q:是否支持本地开源模型权重直接接入,而不使用API?
A:原生默认API调用模式;开发者可以修改agent模块客户端代码,对接本地部署大模型推理接口,适配本地开源权重。
Q:仿真环境里面供应商底价是否会随机变化?
A:不会,E‑CommerceBench仿真属于确定性环境,供应商底价、市场事件全部固定,只有大模型输出存在随机性,保证实验可复现。
Q:为什么不能只用最终资产乘数单一指标评判模型好坏?
A:实验数据显示,部分模型获得较高资产收益,但会出现较高欺诈采购占比,依靠冒险策略获利,议价能力、风控能力表现较差,单一收益指标会掩盖模型能力短板,需要结合全套多维指标综合评判。
Q:数据集是否可以导出直接拿来训练大模型?
A:数据集跟随仓库开源,需要遵守Apache‑2.0许可协议;注意原始数据经过脱敏处理,仅适配本仿真环境,不建议直接拿来做通用电商训练集。
八、相关链接
GitHub开源仓库:https://github.com/QwenLM/E-CommerceBench
arXiv论文地址:https://arxiv.org/abs/2608.30730
九、总结
E‑CommerceBench是一套面向电商商业场景的长周期智能体评测基准,跳出传统单点问答与离散任务测试模式,依托脱敏真实电商数据搭建完整可复现的365天虚拟商家经营环境,不仅可以衡量大模型最终经营收益,还能同时考察谈判博弈、风险识别、现金流管控、超长上下文记忆与工具调用效率等多种真实Agent核心能力,项目完整开放仿真代码、数据集与评估工具链,为长时序商业智能体的模型迭代、科研对比提供标准化实验平台。
版权及免责申明:本文由@AI工具集原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/e-commerce-bench.html