FLUX‑3‑Max:fal基于FLUX3优化的高速AI音视频生成模型
一、FLUX‑3‑Max是什么
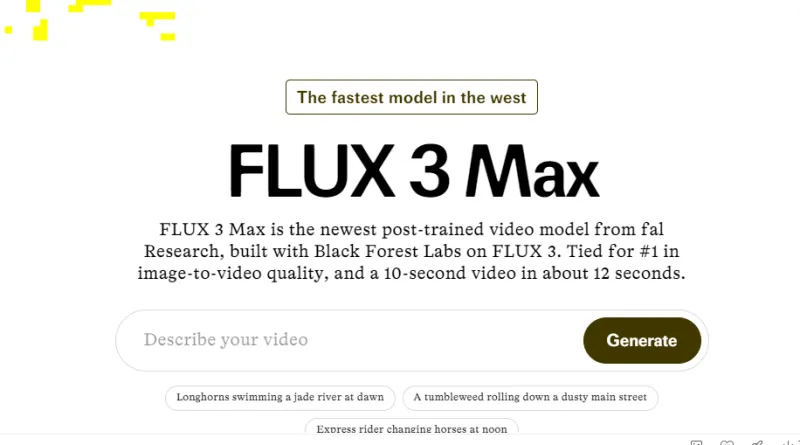
FLUX‑3‑Max是fal Research基于Black Forest Labs FLUX 3多模态基座二次精调后的高性能视频生成模型,属于FLUX 3 Video系列增强版本,主打文生视频、图生视频,在画面一致性、文字渲染、生成速度上做了专项后训练优化,在盲测人类偏好榜单中取得靠前成绩。
它依托FLUX 3统一多模态架构,同步学习图像、视频、音频信息,生成视频时原生配套同步音频,支持多语种对白、环境音效,是面向创作者、开发者、内容工作室的云端AI视频生成模型,通过fal平台API与在线演示页对外提供服务。
二、功能特色
文生视频、图生视频双核心模式:输入提示词直接生成视频;上传参考图作为起始帧或者风格参考生成动态短片,支持画面角色与主体特征保留。
原生音画同步生成:音频随视频一同生成,包含环境音、多语言人声对白,自带口型匹配效果,无需后期单独配音,音频不额外计费。
高精度文字与排版渲染:在视频画面内稳定生成文字、标识、排版图案,相比很多同类模型文字错乱、变形问题更少,适合广告、动态海报、字幕类短片。
多画幅适配:支持9:16竖屏、16:9、4:3、21:9等主流比例,短视频、影视宽幅、方形宣传素材都可以直接生成。
草稿预览模式:可以优先生成低画质草稿快速验证创意、镜头构图,确认效果后再渲染高清成片,节省调试成本与费用。
生成速度大幅优化:经过后训练与推理优化,同等画质下生成速度远高于原版FLUX 3,10秒视频生成耗时显著缩短,适合批量出片场景。
风格覆盖广:实拍纪实、电影质感、二维动画、动态设计、艺术风格都可以稳定输出,风格迁移能力强。
三、技术细节
FLUX‑3‑Max底层基于Black Forest Labs FLUX 3统一多模态基础模型做Post‑Training后训练优化,不是独立从零训练的基座模型,在保留FLUX3音视频联合预测机制的前提下,针对运动连贯性、文本渲染、推理效率做专项调优。
模型采用统一时序扩散预测架构,图像、视频、音频共享世界表征,学习物体结构、运动逻辑、声音事件之间的关联关系,而不是图像、音频、视频分开独立建模。
规格参数:单次最大生成时长20秒,帧率24fps;支持HD、FHD分辨率输出;提供草稿模式用于快速预览;API采用异步任务机制,提交任务后轮询获取结果,支持Python、JS客户端快速接入。
评测数据:在Artificial Analysis图生视频盲测榜单Elo分数1139,和Seedance 2.5同分,生成速度对比Seedance 2.5提升约22倍,对比原版FLUX3提升明显。
说明:FLUX‑3‑Max目前仅在fal平台提供服务,暂无开源权重,和开源权重版本FLUX 3 Action不属于同一产品线。
四、应用场景
短视频创作者:抖音、小红书竖屏剧情短片、产品种草视频、动态海报、口播短片,原生音频省去配音流程。
电商与品牌:商品动态展示、广告创意分镜、品牌宣传片小样、包装设计动态预览。
动画与设计团队:动画分镜预演、动态图形MG动画、概念短片、艺术视觉实验。
开发者与SaaS服务商:将视频生成API接入自有平台,搭建AI视频工具、智能剪辑、素材生产系统。
教育、自媒体:科普动态演示、故事短片、可视化内容素材制作。
五、使用方法
FLUX‑3‑Max有两种使用途径:在线网页体验、API开发接入。
网页端免代码使用:打开fal.ai对应的FLUX‑3‑Max演示页面,选择text-to-video或者image-to-video模式;填写正向提示词,描述主体、动作、镜头、光影、风格;设置画幅、时长、是否开启草稿预览、是否生成音频;提交任务,等待渲染完成,直接下载MP4成片。
API接入开发:注册fal账号,获取API Key;使用官方提供的Python或者JavaScript SDK;调用对应的
blackforestlabs/flux-3-max/text-to-video、blackforestlabs/flux-3-max/image-to-video端点;传入prompt、参考图链接、时长、分辨率、画幅等参数;接口异步返回任务ID,循环轮询任务状态,任务完成后读取视频资源链接。
计费模式:按视频生成时长按量计费,订阅费、席位费,草稿模式单价更低。
六、竞品对比
| 对比项 | FLUX‑3‑Max | Runway Gen3 | Seedance 2.5 |
|---|---|---|---|
| 底层来源 | FLUX3基座 fal后训练增强 | Runway自研Gen系列基座 | 字节Seed系列自研基座 |
| 核心优势 | 文字渲染强、音画同步、推理速度快,提示词跟随稳定 | 镜头控制工具丰富,后期编辑能力强,生态成熟 | 长镜头稳定性强,画面质感细腻,长叙事表现优秀 |
| 原生音频 | 支持同步生成音频 | 音频需要单独生成,无原生联动 | 支持原生同步音频 |
| 部署方式 | 仅fal云端API,不开源 | 云端网页+API,不开源 | 云端API为主 |
| 适合人群 | 批量做带文字的广告、短视频、需要快速试稿 | 专业影视创作者,重度视频编辑需求 | 动画、长镜头叙事类内容创作 |
| 短板 | 暂不支持视频续拍、关键帧控制能力有限 | 生成单价偏高,批量生产成本高 | 生成速度慢,长视频耗时久 |
七、常见问题解答
Q:FLUX‑3‑Max和原版FLUX 3 Video有什么区别?
A:FLUX 3 Video是Black Forest Labs官方原生版本;FLUX‑3‑Max是fal Research在原版FLUX3基础上做后训练优化的增强版本,重点优化了生成速度、画面一致性、文字生成效果,评测指标有提升,由fal平台维护和提供调用服务。
Q:FLUX‑3‑Max可以本地部署吗?
A:不可以,FLUX‑3‑Max没有开源权重,只能通过fal平台网页或者API调用;FLUX产品线里FLUX 3 Action是开源权重模型,二者不要混淆。
Q:生成出来的视频版权可以商用吗?
A:商用权限需要参考fal平台的用户协议,不同套餐权限不一样,正式商用前建议查阅fal官方许可条款。
Q:FLUX‑3‑Max支持中文提示词吗?
A:支持中文提示词,但模型原生训练数据以英文为主,复杂中文长句、本土化专有名词,英文提示词效果通常更稳定。
Q:为什么我生成的视频人物手部容易崩坏?
A:属于当前一代视频扩散模型共性问题,复杂肢体、快速运动场景容易出现肢体畸变;可以在提示词增加约束描述,降低镜头运动幅度,使用草稿模式多次调试。
Q:FLUX‑3‑Max支持视频生视频、关键帧生成吗?
A:当前FLUX‑3‑Max仅开放文生视频、图生视频两个接口,暂不支持视频到视频、关键帧驱动生成,原版FLUX3 Video才有更多输入模式。
八、相关链接
fal FLUX‑3‑Max主页:https://fal.ai/flux-3-max
Black Forest Labs FLUX 3官方介绍页:https://bfl.ai/models/flux-3-video#flux-3-max
FLUX 3官方文档地址:https://docs.bfl.ml/flux_3/flux3_overview
九、总结
FLUX‑3‑Max依托FLUX3成熟多模态底座,通过fal针对性后训练优化,在文字生成、推理速度、音画同步上形成差异化优势,作为一款面向批量素材生产的云端AI视频模型,操作门槛低,API友好,适合短视频、广告动态素材、MG设计等场景,虽然缺少视频续拍、关键帧等高阶控制能力,但在快速试稿、批量出片场景拥有不错的实用性。
版权及免责申明:本文由@AI铺子原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/flux-3-max.html