HelixWorld:NoizAI联合港科大推出实时交互式音视频世界模型
一、HelixWorld是什么
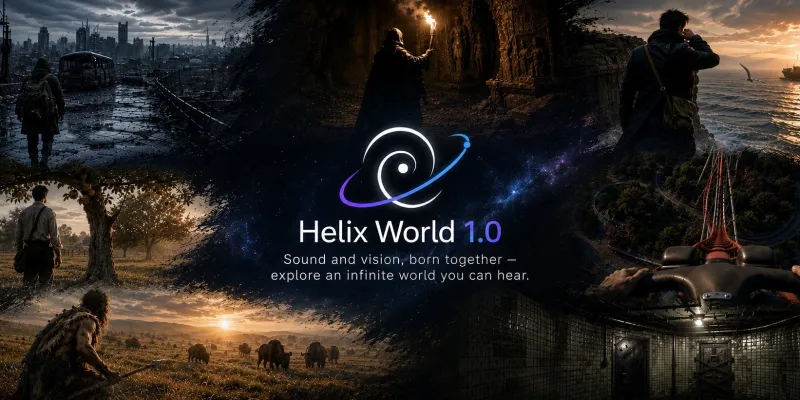
HelixWorld 是由 NoizAI 联合香港科技大学发布的实时交互式音视频世界模型,属于原生音画一体化生成的AI世界模型项目。
它区别于传统一次性生成短视频的模型,支持用户以第一人称视角自由漫游虚拟场景,输入一张初始图片与场景描述文本,即可生成可交互的连续虚拟空间;用户移动、转动镜头时,画面与空间立体声会同步实时变化,声音声源方向跟随相机视角联动调整,打造沉浸式可探索AI虚拟世界体验。
项目配套开源代码、预览权重、在线演示Demo与学术论文,当前开放预览版本,完整代码与权重分阶段对外发布。
二、功能特色
音画联合实时生成:原生Transformer架构同步生成视频与立体声,不是视频生成后再叠加音频,输出规格为24FPS画面、48kHz双声道立体声,音画时序保持同步。
空间声场跟随视角:核心差异化能力,当用户转动镜头、前后移动时,立体声声源方位同步改变,模拟真实3D空间听觉效果,远处、侧方、身后声源位置会随视角实时更新。
第一人称交互式漫游:支持WASD按键移动、方向键旋转视角,用户操作会实时输入模型,持续延展生成场景,世界会跟随你的行动不断拓展。
图片+文本启动场景:上传一张起始参考图,搭配文本提示词定义环境风格,即可快速创建海底、森林、古堡、雪山等各类虚拟场景。
长时序稳定性优化:专门针对长时间连续生成做优化,缓解画面漂移、音频失真退化问题,支持持续漫游探索。
单卡实时推理:在单张NVIDIA H800显卡热启动后,768×512分辨率下可实现实时推理,实时因子0.77,算力输出速度满足交互漫游需求。
三、技术细节
HelixWorld 基于LTX‑2.3音视频模型底座开发,采用音视频联合Transformer架构,视觉分支与音频分支共享动作、相机姿态输入,实现统一建模。
训练数据集包含约3000小时带立体声、相机运动轨迹标注的视频片段,每条样本同时记录画面内容、空间音频、相机位移旋转信息,模型学习相机动作、视觉变化、空间声音三者之间的关联关系。
推理阶段采用分段生成策略,一次性生成约1.3秒音视频片段,用户新的移动操作会在下一个生成片段生效;搭配模型蒸馏技术,减少每一轮生成的计算步数,降低实时交互延迟。
模型内置相机姿态编码器,将WASD、方向键转换为相机位移、旋转向量,作为条件输入,驱动视觉与音频模块同步更新。同时增加时序约束模块,抑制长时间连续生成时的画面漂移、音频崩坏现象。
项目配套HelixBench评测基准,用于评估交互式世界模型的音画一致性、空间声场准确性、场景连贯性。
四、应用场景
沉浸式内容创作:短剧、虚拟场景、游戏预演、VR素材快速生成,创作者自由漫游场景,直接截取漫游画面与空间音频素材。
虚拟仿真与具身智能:机器人、智能体仿真环境搭建,低成本生成带空间声音的训练环境,用于智能体视觉听觉联合训练。
文旅数字体验:虚拟景区漫游,游客第一人称探索数字复刻景点,搭配空间立体声,提升数字文旅沉浸感。
教育可视化:地理、地质、古文明场景还原,学生交互式漫游虚拟场景,搭配环境音效辅助教学。
原型快速验证:游戏、影视前期场景概念验证,无需三维建模,图片+文字快速生成可漫游虚拟世界。
五、使用方法
在线Demo使用(推荐新手)
打开官方演示网站 helixworld.org
上传一张起始参考图片,填写场景描述提示词
点击启动生成,进入漫游界面
使用WASD控制前后左右移动,方向键旋转镜头,实时漫游AI生成的虚拟场景
可导出漫游过程中的视频与音频素材
本地部署使用
克隆项目仓库
git clone https://github.com/NoizAI/HelixWorld.git
cd HelixWorld
前往Hugging Face下载 HelixWorld-preview 模型权重,放置到项目权重目录
安装项目依赖环境(CUDA、PyTorch等)
启动推理服务,加载权重,上传初始图片、填写提示词,开启本地交互式漫游
本地部署硬件门槛较高,推荐NVIDIA H800级别显卡,普通消费显卡无法流畅实时推理。
六、竞品对比
选取2款主流交互式世界模型进行对比:Genie 3(DeepMind)、PixVerse R1(爱诗科技)
| 对比维度 | HelixWorld | Genie 3(DeepMind) | PixVerse R1 |
|---|---|---|---|
| 核心定位 | 实时交互式音视频一体化世界模型 | 交互式视觉世界模型 | 实时纯视觉世界模型 |
| 音频能力 | 原生48kHz立体声,空间声场跟随镜头转动 | 仅画面生成,无原生空间音频,需要后期配音 | 只生成画面,不内置音频生成模块 |
| 交互方式 | WASD+方向键第一人称漫游 | 文本指令+相机视角控制 | 视角漫游交互 |
| 输出帧率 | 24FPS | 最高24FPS | 最高24FPS,支持1080P分辨率 |
| 技术特点 | 音画联合Transformer,同步建模视觉、音频、相机运动 | 视觉为主,侧重场景物理一致性 | 纯视觉视频生成路线,画面清晰度优势明显 |
| 开源状态 | 预览版代码与权重开放,分阶段发布完整版本 | 闭源,仅提供网页Demo | 闭源,面向企业服务 |
七、常见问题解答
问:HelixWorld 本地部署最低显卡要求是什么?
答:官方推荐单张NVIDIA H800显卡才能流畅实现768×512分辨率24FPS实时交互。普通消费级显卡如RTX4090算力不足,无法达到实时漫游效果,会出现明显卡顿。
问:HelixWorld生成的声音是普通背景音乐吗?
答:不是背景音乐。模型原生生成空间立体声,声音会跟随镜头方位变化,模拟真实空间声源;当你转身,声源的左右声道响度、相位同步变化,实现3D听觉效果,不是简单叠加固定音频轨道。
问:项目代码是否全部开源?
答:目前开放预览版本代码与预览权重,完整代码与完整模型权重会分阶段逐步对外发布,现阶段不提供全部源码。
问:可以上传任意图片作为场景起点吗?
答:支持大部分图片作为初始场景图,优先推荐风景、环境类图片;人像特写、复杂物体特写图片,后续漫游时更容易出现画面漂移。
问:生成的视频素材是否可以商用?
答:素材商用需要遵循项目对应的模型权重许可协议,建议阅读仓库内License文档,明确商用授权范围。
问:长时间漫游会不会出现画面崩坏?
答:模型做了时序优化,缓解漂移问题,但无限长时间连续生成依然存在累积误差,漫游时长建议分段进行。
八、相关链接
GitHub仓库:https://github.com/NoizAI/HelixWorld
Hugging Face模型权重:https://huggingface.co/NoizAI/HelixWorld-preview
在线演示Demo:https://helixworld.org
九、总结
HelixWorld 是一款主打音画一体化交互能力的开源预览世界模型,补齐了传统世界模型缺少原生空间音频的短板,通过相机姿态与音视频联合建模,实现镜头联动的沉浸式漫游体验,兼顾网页端快速试用与本地部署能力,为虚拟内容创作、具身智能仿真、数字文旅等领域提供了全新的交互式AI场景生成方案。
版权及免责申明:本文由@人工智能研究所原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/helixworld.html