Hy Memory 2.0:腾讯混元开源的AI智能体记忆框架
一、Hy Memory 2.0 是什么
Hy Memory 2.0 是腾讯混元于2026年10月16日正式开源的AI智能体长期记忆完整解决方案,采用模型、框架、应用三层全开源设计,三层组件可独立部署使用,也可组合搭建完整记忆系统。
传统大模型仅能在单次会话内保留上下文,跨会话会丢失历史信息,存在上下文膨胀、信息冲突、记忆幻觉、推理成本高等痛点。Hy Memory 2.0 的核心思路不是存储全部原始对话,而是对历史信息做提炼、关联、更新与召回,让AI智能体跨会话、跨工具稳定记住用户偏好、任务进展、代码变更等信息,已经在腾讯内部金融、办公Agent、知识管理、游戏等业务落地使用。
二、功能特色
三类记忆原生支持
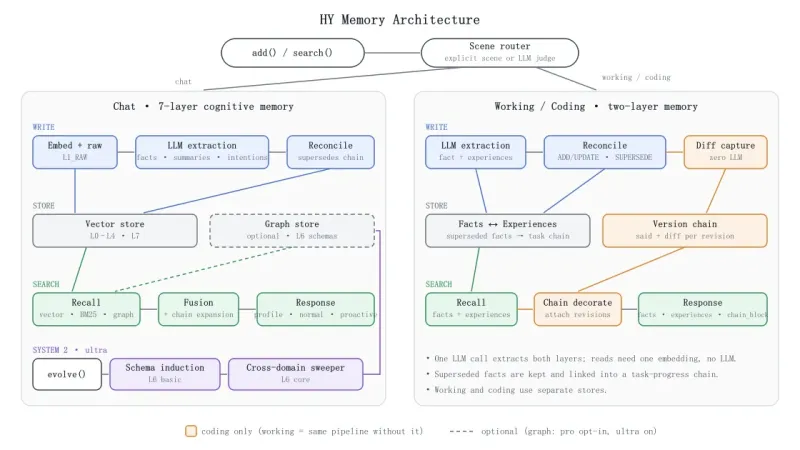
业界首个原生同时支持聊天记忆、工作记忆、代码记忆三大记忆类型的开源框架。聊天记忆提取用户个人偏好、事实信息;工作记忆记录任务目标、阶段性成果、业务决策;代码记忆留存代码变更记录、调试背景、版本链路,面向开发Agent场景深度优化。分层记忆与冲突自动处理
聊天记忆采用L1-L7共8层分层记忆结构,自动完成信息提取、去重、冲突修正、记忆合并,减少冗余信息,降低prompt膨胀。可插拔存储后端
向量库、图数据库、关系型数据库均可自由替换,兼容ChromaDB、Qdrant、FAISS、Kuzu、Neo4j、SQLite,适配本地、服务器多种部署环境。MemHub跨AI工具记忆同步
配套MemHub应用,提供Mac桌面端与CLI命令行工具,可统一管理Cursor、Claude Code、Codex等十余款AI工具会话历史,一次沉淀记忆,多AI工具共享,不用重复交代需求。独立专用记忆模型
配套Hy-Memory-30B-A3B记忆专用MoE模型,专门负责记忆写入、更新、召回与校验,不依赖基座大模型处理记忆逻辑,在4项主流记忆评测基准中综合表现领先同类型开源方案。
三、技术细节
Hy Memory 2.0 整体采用双系统认知架构(System1+System2),拆分快速记忆检索与深度记忆推理两大模块,平衡响应速度与记忆准确性。
模型层:Hy-Memory-30B-A3B
MoE混合专家架构,总参数量30B,每token激活3B参数,专门作为记忆读写专用模型,负责事实抽取、记忆合并、矛盾信息校验、时序推理,可独立嵌入Mem0、MemOS等第三方记忆框架。模型权重开源,支持本地私有化部署。框架层:Hy Memory Engine Python SDK
核心引擎,封装三类记忆生命周期管理逻辑:记忆抽取、持久化存储、相似度召回、记忆更新、过期归档。提供PyPI包,少量代码即可接入现有AI Agent项目。应用层:MemHub
本地优先设计,会话数据本地存储,支持历史对话批量导入、记忆预览、手动编辑记忆、跨AI工具同步记忆。
记忆处理流程:用户对话输入 → 专用模型抽取关键事实 → 分层写入对应存储引擎 → 用户发起新请求时,检索相关记忆注入上下文 → 识别信息冲突自动更新旧记忆。
四、应用场景
AI开发Agent:长期记住项目约定、代码修改背景、历史bug与调试方案,持续迭代项目,不用每次重新介绍项目结构。
企业办公智能体:跟进长期项目,沉淀会议结论、业务约束、客户偏好,跨会话完成文档分析、报表生成、方案撰写。
个人AI助手:跨多个AI工具统一记忆个人偏好、历史需求,减少重复描述,提升连续使用体验。
行业业务Agent:金融、知识管理、游戏场景,长期维护业务知识库、用户行为、项目决策记录,支撑持续多轮业务交互。
五、使用方法
环境准备
安装Python环境,通过PyPI安装Hy Memory SDK;按需部署向量/图数据库,也可直接使用内置SQLite轻量存储快速测试。模型部署(可选)
从Hugging Face下载Hy-Memory-30B-A3B模型权重,本地部署;不部署该模型,也可以接入第三方LLM完成基础记忆能力。代码接入SDK
引入hy-memory包,初始化记忆引擎,绑定用户ID/Agent ID,传入对话消息,框架自动抽取并保存记忆;查询时引擎自动召回相关记忆。MemHub桌面工具使用
下载MemHub客户端,授权绑定各类AI开发工具,导入历史会话,自动沉淀记忆,在多个AI工具之间同步记忆内容。
六、竞品对比
选取Mem0、MemOS两款主流开源AI记忆框架进行对比:
| 项目 | Hy Memory 2.0 | Mem0 | MemOS |
|---|---|---|---|
| 核心定位 | 三层完整记忆方案,原生支持聊天/工作/代码三类记忆 | 轻量化AI智能体记忆层,主打通用聊天记忆 | 操作系统式统一记忆管理,侧重多Agent共享记忆 |
| 配套模型 | 自带专用MoE记忆模型Hy-Memory-30B-A3B | 无配套专用记忆模型,依赖外部LLM | 无配套专用记忆模型 |
| 存储方案 | 可插拔向量库、图数据库、关系数据库 | 托管向量存储,自托管可选 | 向量+KV缓存混合存储 |
| 特色能力 | MemHub跨AI工具记忆同步,代码记忆专项优化 | 开箱即用托管服务,企业审计日志 | 多Agent共享记忆、毫秒级响应 |
| 部署模式 | 本地优先,全栈开源,私有化友好 | 云端托管为主,支持自托管 | 云端API优先,开源内核 |
七、常见问题解答
问:Hy Memory 2.0是否必须部署Hy-Memory-30B-A3B模型才能使用?
答:不需要。Hy Memory Engine框架本身可以脱离专用模型独立运行,接入其他大模型完成基础记忆抽取与召回;部署Hy-Memory-30B-A3B模型可以大幅提升记忆冲突处理、时序推理、代码记忆的准确性,属于增强项。
问:MemHub支持Windows版本吗?
答:当前MemHub桌面客户端仅提供Mac版本,跨平台可使用CLI命令行工具,Windows、Linux系统均可通过CLI使用记忆管理能力。
问:Hy Memory 2.0的记忆数据默认存储在哪里?
答:默认本地存储,支持SQLite、向量库、图数据库本地部署,不会强制上传第三方云端;企业用户可自行配置存储后端,满足数据私有化合规要求。
问:Hy Memory 2.0可以和Cursor、Claude Code以外的AI工具对接吗?
答:可以,MemHub支持十余款主流AI开发工具,后续版本还会持续扩充适配列表,开发者也可以基于SDK自行开发插件接入其他AI应用。
问:Hy Memory 2.0是完全免费开源吗,是否可以商用?
答:项目整体开源,开发者可基于开源协议进行二次开发和商用,使用前需要阅读项目仓库内开源许可证,遵守对应协议约束。
八、相关链接
Hy Memory SDK与MemHub项目GitHub仓库:https://github.com/Tencent-Hunyuan/Hy-Memory
Hy-Memory-30B-A3B模型权重 Hugging Face地址:https://huggingface.co/tencent/Hy-Memory-30B-A3B
九、总结
Hy Memory 2.0 是腾讯混元推出的三层全开源AI智能体长期记忆解决方案,依靠专用记忆模型、多类型记忆引擎与MemHub跨工具记忆管理工具,解决AI智能体跨会话记忆丢失、上下文膨胀、信息冲突等问题,原生适配聊天、办公、代码三大高频场景,提供可插拔存储架构,兼顾本地私有化部署与二次开发需求,已经在腾讯内部多个业务落地,为AI Agent开发者提供一套完整可用的长期记忆基础设施。
版权及免责申明:本文由@97ai原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/hy-memory-2-0.html