LLM‑as‑a‑Verifier:斯坦福伯克利英伟达开源的Agent细粒度验证框架
一、什么是LLM‑as‑a‑Verifier
LLM‑as‑a‑Verifier是由斯坦福大学、UC伯克利、英伟达联合推出的开源Agent验证框架,基于MIT开源协议发布。
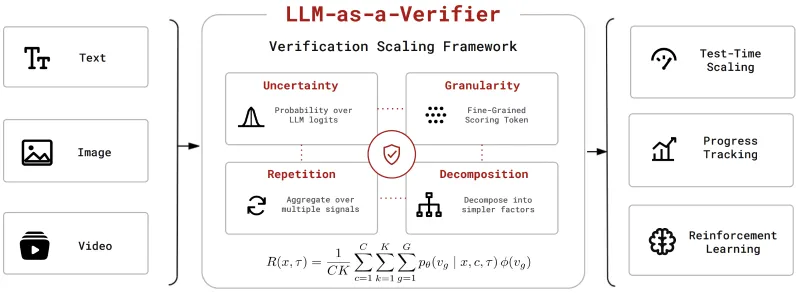
它属于新一代LLM‑as‑Verifier范式,区别传统LLM‑as‑Judge离散打分,不需要对大模型做额外微调训练,直接调用任意兼容OpenAI接口的大模型作为验证器,对Agent完整推理轨迹输出0‑1区间连续细粒度奖励信号,支持候选择优、步骤进度监控、实时终止失败任务、生成强化学习奖励,同时兼容文本与多模态图像输入,在Terminal‑Bench、SWE‑Bench Verified等多个Agent基准上取得SOTA效果。
简单理解:传统方案只能给最终结果打1‑10分;该项目可以对Agent每一步动作打分,追踪任务推进进度,从多条候选轨迹中选出最优方案,也可以直接输出奖励值供给强化学习流程。
二、功能特色
细粒度连续奖励输出:不输出简单离散分数,基于token logprob概率分布计算期望,输出0‑1连续奖励值,还原任务完成程度。
概率Pivot锦标赛PPT择优算法,把候选对比复杂度从$O(N^2)$降低到$(O(Nk))$,高效完成Best‑of‑N候选轨迹筛选,规避Prompt位置偏差。
轨迹进度追踪:
ProgressTracker组件支持在线实时评估Agent每一步输出,识别无望任务,支持提前终止、触发重采样,不用等待完整任务结束。多任务评估API:封装
select()、compare()、track()三大核心接口,开箱即用,分别实现候选择优、成对轨迹对比、完整轨迹全链路打分。多模态支持:支持传入图片路径、URL,适配视觉Agent、机器人智能体场景。
前缀缓存优化:长轨迹评估场景优化缓存命中率,降低token消耗,v0.2.0版本未缓存输入token减少约3.4倍。
完整Token统计:统计缓存、输入输出token用量,方便做成本核算。
基准与自定义任务扩展:内置Terminal‑Bench2.1等基准,支持自定义业务Agent任务接入。
三、技术细节
3.1 核心技术原理
基于Logprob的细粒度奖励计算
框架不依赖模型输出数字,而是让模型输出A‑T的评分token,读取每个token的logprob概率分布,求数学期望得到0‑1之间连续奖励;支持多条评估标准、多次重复评估做加权平均,降低单次LLM输出随机性带来的误差。概率Pivot锦标赛(PPT)
传统两两对比需要N²次调用,成本极高。PPT算法选取pivot基准候选集,其余样本仅和pivot做对比,复杂度降至$(O(Nk))$;同时通过轮换Prompt顺序抵消位置偏见,在降低算力开销的同时保证择优精度,用于Best‑of‑N策略。ProgressTracker在线进度追踪
Agent每输出一步,框架就执行一次评估,输出当前任务完成度分数;当分数持续低于阈值,可直接终止当前任务,触发重采样,节约推理时间与token消耗。缓存优化策略
将评估标准放置在Prompt末尾,最大化前缀缓存复用,长Agent轨迹重复评估时大幅减少重复token开销。
3.2 项目工程目录
| 目录/文件 | 作用说明 |
|---|---|
llm_verifier/ | 框架核心源码,API、打分、PPT算法实现 |
scripts/ | 命令行脚本,复现基准、可视化评估结果 |
criteria/ | 各任务评估标准Prompt模板 |
data/ | 存储Agent轨迹数据集 |
cache/ | 自动生成,评估分数缓存文件 |
results/ | 自动生成,输出实验结果 |
3.3 后端依赖
验证器后端需要支持返回logprobs,兼容DeepSeek、Gemini、vLLM部署开源模型等所有OpenAI兼容接口。
四、应用场景
AI Agent候选择优Best‑of‑N:Agent生成多条执行轨迹,使用框架选出最优轨迹,提升终端任务成功率,代码Agent、终端Agent场景效果显著。
Agent运行时监控:实时监控Agent每一步动作,识别卡死、方向跑偏的任务,提前终止,触发重采样,降低无效算力消耗。
强化学习奖励信号生成:输出连续奖励值,直接作为RL训练的reward,替代人工标注奖励。
Agent自动化评测:对Agent轨迹做细粒度评测,不只是看最终输出,评估中间步骤合理性,用于Agent迭代测试。
多模态智能体评估:结合图像输入,评估机器人、视觉Agent任务完成质量。
自定义业务Agent评估流水线:企业内部自建Agent,接入框架实现自动化质量评估。
五、使用方法
5.1 安装
方式1,pip直接安装
pip install llm-verifier
方式2,本地源码可编辑模式安装
git clone https://github.com/llm-as-a-verifier/llm-as-a-verifier
cd llm-as-a-verifier
pip install -e .
5.2 极简Python代码示例
import llm_verifier

problem = "编写一个字符串反转函数"
candidates = [
  "def rev(s): return s[::-1]",
  "def rev(s): return s"
]
# criteria定义评估维度
criteria = {"Correctness":"代码是否正确实现字符串反转逻辑"}

result = llm_verifier.select(problem=problem, candidates=candidates, criteria=criteria)
print("最优候选索引:", result.index)
print("各候选得分:", result.scores)
5.3 接入自定义任务
将轨迹数据放置到
data/<task>_trajs/目录;参考项目文档
add_new_benchmark.md编写任务配置;在
llm_verifier/benchmarks.py注册自定义基准,即可复用打分、择优、脚本复现全部能力。
六、竞品对比
选取DeepEval(G‑Eval)、原生LLM‑as‑Judge、LLM‑as‑a‑Verifier三方对比,聚焦Agent轨迹评估维度。
| 对比维度 | LLM‑as‑a‑Verifier | DeepEval G‑Eval | 传统LLM‑as‑Judge |
|---|---|---|---|
| 评分输出 | 0‑1连续奖励,基于logprob概率期望 | 离散1‑5分文本输出 | 离散数字打分/布尔判断 |
| 轨迹逐步骤评估 | ✅支持实时进度追踪,可提前终止任务 | ❌仅支持完整输出评估 | ❌大多只评估最终结果 |
| 候选择优算法 | ✅PPT概率锦标赛,低开销做Best‑of‑N | ❌无内置择优算法 | ❌仅成对对比,算力开销O(N²) |
| 多模态 | ✅支持图像输入 | ✅基础多模态 | 部分实现 |
| 强化学习奖励输出 | ✅原生输出可直接使用的reward信号 | ❌需要二次转换 | ❌不适合直接做RL奖励 |
| 缓存优化 | ✅前缀缓存,长轨迹降token消耗 | ❌无专门缓存优化 | ❌无缓存策略 |
| 开源协议 | MIT | MIT | 大多为代码片段,无完整工程封装 |
七、常见问题解答
Q:运行该项目是否需要对大模型进行微调?
A:不需要,该框架是验证调度层,直接调用外部大模型API,不需要微调、训练任何模型权重,仅需要后端接口支持logprobs返回。
Q:哪些大模型后端可以作为验证器使用?
A:所有兼容OpenAI接口,并且支持返回token logprobs的模型,例如DeepSeek、Gemini‑2.5‑Flash、vLLM部署的开源模型;不支持logprobs的接口无法运行。
Q:自验证(生成Agent和验证器为同一个模型)效果靠谱吗?
A:论文实验显示自验证可以显著提升Best‑of‑N成功率,但存在认知偏差风险;生产环境建议尽量使用独立的不同模型作为验证器。
Q:PPT概率锦标赛算法相比全量两两对比优势是什么?
A:全量两两对比复杂度O(N^2),候选数量多的时候调用量爆炸;PPT算法降低到$(O(Nk))$,大幅减少LLM调用次数,同时通过轮换Prompt顺序缓解位置偏见。
Q:可以用于非Agent普通对话任务评估吗?
A:可以,框架原生面向Agent轨迹设计,普通对话也可以传入候选文本做select择优,但进度追踪、step级监控能力无法发挥价值。
Q:如何降低评估结果的随机性?
A:开启多次重复评估,框架会对多次输出做加权平均;同时合理拆分criteria评估维度,细化评估标准。
Q:支持本地开源模型部署吗?
A:支持,使用vLLM等工具部署开源模型,开启OpenAI兼容接口,同时开启logprobs输出即可接入。
八、相关链接
项目GitHub地址:https://github.com/llm-as-a-verifier/llm-as-a-verifier
ArXiv论文地址:https://arxiv.org/abs/2607.05391
项目官网地址:https://llm-as-a-verifier.com/
九、总结
LLM‑as‑a‑Verifier是一套完整可落地的Agent轨迹验证开源工程,解决传统LLM‑as‑Judge离散打分、算力成本高、无法逐步骤监控Agent执行过程的痛点,借助logprob概率计算与PPT锦标赛算法,在不微调模型的前提下提供连续奖励、候选择优、实时任务监控能力,适配Agent开发、自动化评测、强化学习奖励生成等场景,提供完整工程封装与基准数据集,开发者可以直接集成到自己的AI智能体项目中。
版权及免责申明:本文由@AI工具箱原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/llm-as-a-verifier.html