MiniCPM-V 4.7:面壁智能开源的侧端MoE多模态模型
一、MiniCPM-V 4.7是什么
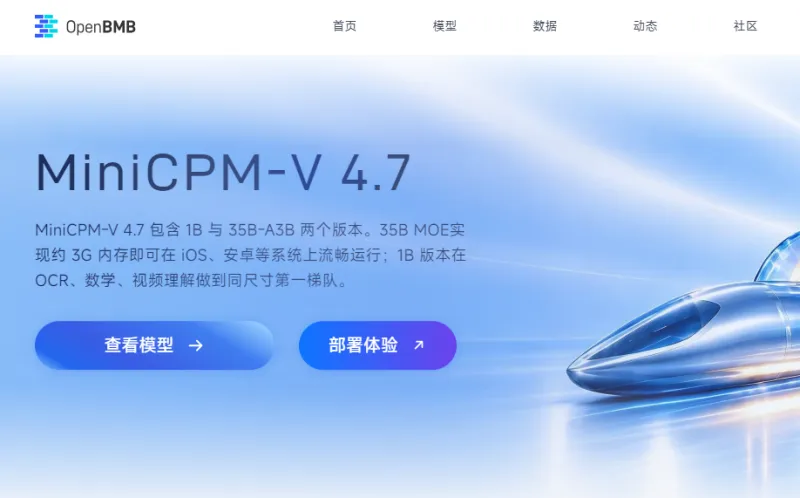
MiniCPM-V 4.7是面壁智能OpenBMB开源的新一代多模态视觉语言大模型,采用Apache 2.0开源协议,包含两个变体:35B-A3B MoE混合专家版本(系列首个MoE多模态模型)以及1B稠密轻量版本。该模型主打端侧本地推理,支持图片、多图、PDF文档、视频理解、OCR文字识别,最高支持256K上下文窗口,可在手机、平板、消费级PC、服务器GPU上部署运行,兼顾强视觉理解能力与低硬件开销。
二、功能特色
多模态综合理解:支持单图、多张图片联合推理,长视频内容问答,PDF、扫描文档、表格、截图的文字提取与解析,场景OCR识别能力突出。
端侧MoE高效推理:35B-A3B版本总参数量35B,每次推理仅激活3B参数,大幅降低计算负载;量化后可在iPhone、iPad等移动设备流畅运行,iPhone 17 Pro Max上可达13 tokens/s以上推理速度。
可调节视觉Token压缩:内置ViT内早期压缩技术,支持4倍、16倍视觉token压缩切换,开发者可按需在识别精度与推理速度之间取舍。
超长上下文支持:最高256K上下文窗口,适合长文档、多图串联、长视频字幕与图文混合内容分析。
多平台多框架兼容:原生支持HuggingFace、vLLM、SGLang、llama.cpp、Ollama;支持GGUF、AWQ、BNB、INT4、FP8等多种量化格式,适配iOS、安卓、鸿蒙、英特尔CPU/GPU/NPU。
多语言能力:支持30+语种图文理解,中文图文指令跟随表现优秀,可完成图表分析、代码生成、逻辑推理、视觉定位等任务。
三、技术细节
模型架构:35B-A3B采用MoE混合专家架构;视觉编码器基于SigLIP canvas M-RoPE,沿用LLaVA-UHD v4 ViT内部早期压缩方案。1B为稠密版本,适合低资源设备快速部署。
核心加速技术
LES前瞻专家调度:跨层预加载专家权重,将计算与内存加载重叠,减少等待开销;
逐层混合精度量化+专家权重连续重排,降低内存带宽占用;
DSpark推测解码:草稿模型预生成候选token,主模型批量校验,显著提升端侧解码速度;
分页注意力PagedAttention,优化KV缓存管理,减少内存浪费,支撑长上下文。
授权协议:Apache 2.0,允许商用二次开发,需遵守模型配套许可条款。
量化方案:支持INT4、FP8、GGUF,不同量化等级适配服务器、PC、手机平板等不同硬件。
四、应用场景
本地OCR与文档解析:扫描件、截图、发票、PDF图文提取、表格识别,不依赖云端API。
端侧智能视觉助手:手机、平板离线图片问答、图片内容总结、图文推理。
多图/视频内容分析:批量图片比对、视频帧理解、视频内容摘要。
行业本地私有化部署:企业内网文档质检、设备图像巡检、图文知识库问答,保护数据不外流。
AI应用开发与原型:Agent多模态能力、本地知识库、嵌入式视觉AI产品开发、学术评测与模型微调。
五、使用方法
1. 仓库拉取环境准备
git clone https://github.com/OpenBMB/MiniCPM-V.git
cd MiniCPM-V
pip install -r requirements.txt
2. HuggingFace基础Python推理示例
import torch
from PIL import Image
from transformers import AutoModel, AutoTokenizer

# 加载模型与分词器,可选择 openbmb/MiniCPM-V-4_7-35B-A3B 或 openbmb/MiniCPM-V-4_7-1B
model = AutoModel.from_pretrained("openbmb/MiniCPM-V-4_7-1B", trust_remote_code=True, torch_dtype=torch.bfloat16)
tokenizer = AutoTokenizer.from_pretrained("openbmb/MiniCPM-V-4_7-1B", trust_remote_code=True)

image = Image.open("test.jpg").convert("RGB")
question = "提取图片全部文字,分析图中表格数据"

res, history = model.chat(
  image=image,
  msgs=[{"role":"user", "content": question}],
  tokenizer=tokenizer
)
print(res)
3. Ollama一键快速运行
ollama run openbmb/minicpm-v4.7
4. 其他部署方式
高性能服务:vLLM、SGLang,适合服务器批量图文推理;
CPU/移动端本地:llama.cpp加载GGUF量化权重;
英特尔硬件优化:OpenVINO GenAI、Optimum Intel部署。
六、竞品对比
选取Qwen3.6-VL(35B-A3B MoE)、LLaVA-UHD两个主流开源多模态模型横向对比。
| 对比项 | MiniCPM-V 4.7 | Qwen3.6-VL 35B-A3B | LLaVA-UHD |
|---|---|---|---|
| 模型架构 | 35B-A3B MoE /1B稠密 | 35B-A3B MoE | 稠密LLaVA架构 |
| 上下文窗口 | 256K | 128K | 64K |
| 端侧部署能力 | 优秀,支持iPhone/iPad离线运行,LES+DSpark加速 | 较好,量化可在高端终端运行,缺少专门MoE端侧调度优化 | 一般,侧重GPU服务器,移动端部署性能有限 |
| 视觉Token压缩 | 4x/16x可切换 | 固定压缩策略 | 支持高倍率压缩 |
| 优势场景 | 端侧离线图文、OCR、PDF文档解析,中文指令跟随 | 综合多模态通用任务、长图文推理 | 高清图片理解、科研图像评测 |
| 授权协议 | Apache2.0 | Apache2.0 | 开源学术许可 |
七、常见问题解答
问:MiniCPM-V 4.7两个版本怎么选型?
答:1B稠密版本硬件门槛低,普通PC、低端设备即可本地跑,适合简单图片OCR、基础图文问答原型开发;35B-A3B MoE版本综合推理、复杂文档、视频理解能力更强,需要更高内存,适合高端PC、服务器、高端移动设备离线场景。
问:运行MiniCPM-V4.7最低硬件要求是什么?
答:1B版本INT4量化后,普通消费级GPU(6GB显存)或大内存CPU可运行;35B-A3B量化版本,移动端推荐16GB内存平板/手机;服务器全精度推理需要大显存GPU,INT4量化可降低显存需求。
问:MiniCPM-V4.7是否支持微调?
答:支持,可基于Transformers、LLaMA Factory等框架进行领域微调,适配行业文档、巡检图片等垂直场景,MoE版本微调对硬件资源要求高于1B稠密版本。
问:模型可以商用吗?
答:基于Apache2.0协议,允许商用,使用时需要遵守OpenBMB配套的模型许可协议,不能违反模型使用限制。
问:MiniCPM-V4.7的视频理解支持哪些格式?
答:模型对视频的处理方式是抽取视频关键帧做图文理解,不直接原生读取视频编码流;输入视频文件会自动采样帧进行问答,适合视频内容摘要、画面信息提取,不适合实时视频流低延迟推理。
八、相关链接
项目Github仓库:https://github.com/OpenBMB/MiniCPM-V
HuggingFace模型卡:https://huggingface.co/openbmb/MiniCPM-V-4_7-35B-A3B
魔搭ModelScope模型主页:https://modelscope.cn/models/openbmb/MiniCPM-V-4_7-35B-A3B
面壁智能OpenBMB官网:https://www.openbmb.cn
九、总结
MiniCPM-V 4.7是面壁智能推出的端侧友好型开源多模态模型,通过MoE架构、前瞻专家调度、推测解码与视觉token压缩等多项技术,在保留优秀OCR、文档解析、多图视频理解能力的同时,大幅降低内存与算力消耗,256K超长上下文搭配丰富量化方案,适配手机、平板、PC与服务器等多种硬件平台,开源协议宽松,开发者可以基于该模型快速搭建私有化本地多模态应用,是离线图文视觉场景非常实用的开源选择。
版权及免责申明:本文由@dotaai原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/minicpm-v-4-7.html