PAST‑Bench:面向个人智能体的递归自提升评测数据集与运行框架
简介
PAST‑Bench 是 Gen‑Verse 团队开源的智能体评测基准,专门面向具备持久记忆、跨会话递归自提升能力的个人智能体开展标准化评测。
传统大模型评测大多为独立单轮任务,无法衡量智能体是否能够真正利用历史对话记忆、过往任务经验,在后续会话中实现能力迭代。PAST‑Bench 通过构造有序任务序列,对照开启/关闭持久记忆两种模式,量化评估智能体的经验复用能力,同时支持对智能体行为做归因分析,区分模型原生能力与历史记忆带来的性能增益。
一、PAST‑Bench是什么
PAST‑Bench 是一套面向个人智能体递归自提升的开源评测数据集与运行框架。
它不只是一套测试题目,而是完整的评测系统:包含任务数据集、执行运行器、打分模块、多智能体接入层、对照实验工具链。核心目标是检验智能体跨会话能否留存记忆、复用流程经验、主动检索历史信息、更新过时知识四大核心能力,用来判断智能体是不是真的做到“越用越聪明”,而不是单次任务表现好。
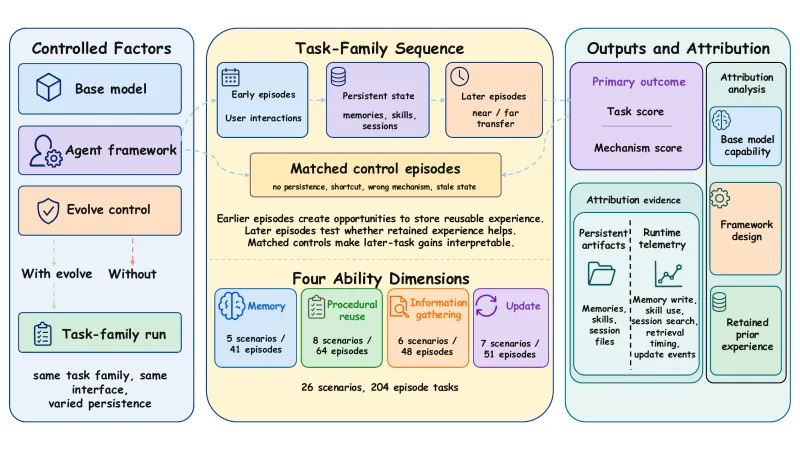
核心逻辑:先执行前置任务积累记忆与经验,再开启全新会话执行后续任务,对比开启持久存储与关闭持久存储两组得分,计算经验带来的真实收益。
二、功能特色
序列式任务评测,而非孤立单任务
任务以 episode 片段序列组织,前面任务产出记忆,后面任务消费历史经验,模拟真实用户长期使用智能体的过程。对照实验原生支持
一键切换持久化存储开关,同一套任务跑两组实验,直接算出历史经验带来的净增益,过滤大模型本身能力带来的分数干扰。四大能力维度完整覆盖
覆盖记忆留存、流程复用、主动信息检索、事实更新四大个人智能体核心能力,合计26个任务家族,204个任务片段。可归因日志追踪
输出完整运行 trace 追踪文件,不只有最终分数,可定位性能提升来自底层大模型、智能体框架,还是历史记忆复用链路。多模型、多智能体兼容
原生接入多款主流大模型,同时内置 Hermes、Hermes+、Nanobot、ZeroClaw、Agent Zero 多种开源智能体实现,方便横向对比。完整实验脚本开箱即用
内置冒烟测试、模型横向对比、智能体横向对比、模块消融实验全套脚本,研究者可以直接批量跑实验。沙箱隔离运行环境
基于 Docker 构建任务沙箱,模拟真实工具调用环境,保证任务执行环境一致性。
三、技术细节
数据集构成
数据集存放在self‑evolve‑tasks‑v2,26个任务家族,204个episode,划分为4个能力方向:
| 能力方向 | 任务家族数量 | 任务片段数量 | 测试目标 |
|---|---|---|---|
| Memory(记忆留存) | 5 | 41 | 持久保存用户偏好、约束、历史案例 |
| Procedural Reuse(流程复用) | 8 | 64 | 复用SOP、故障处理方案、工作流程 |
| Information Gathering(主动信息检索) | 6 | 48 | 任务执行前主动调取历史上下文 |
| Update(事实更新) | 7 | 51 | 修正过期事实,淘汰旧规则 |
代码模块架构
src/past_bench:评测运行器、打分器、指标计算、模型适配层,是基准核心;agents/:各个开源智能体实现,其中 Hermes+ 是该项目提出的增强智能体,新增 Plan、Render、Route、Gate、Close 五大机制,优化记忆读写、路由、更新逻辑;configs/:模型API配置、任务清单配置;scripts/:批量实验、消融实验自动化脚本;mock_services:任务依赖的本地模拟服务;Dockerfile:沙箱容器镜像,用于隔离执行智能体工具调用。
输出产物
每次运行输出三类 JSON 文件:单任务片段得分、任务序列汇总指标、持久化开关对照差值;全部运行 trace 日志存入traces目录,方便事后调试归因。运行依赖
Python3.11,uv包管理器,Docker,大模型API Key;支持 MiniMax‑M2.7、GLM‑5.1、Kimi K2.6、DeepSeek‑V4‑Pro、GPT‑5.4,默认评判模型为 MiniMax‑M2.7。协议说明
项目自研代码 Apache‑2.0;agents/目录下第三方智能体保留原有开源许可证。
四、应用场景
智能体算法研究
科研人员评估记忆增强智能体、递归自提升智能体,验证记忆模块、检索模块的实际收益,做消融实验验证模块价值。大模型应用研发
开发个人助手、长期记忆AI Agent产品,用来验证产品是否真正做到跨会话经验复用,定位记忆模块缺陷。开源智能体横向对比
在统一数据集、统一环境下对比不同开源Agent框架在长期记忆场景的真实表现,避免单任务评测带来的偏差。模型选型测试
固定同一套智能体框架,测试不同基座大模型在持久记忆场景下的能力上限。课程与技术复现
复现论文实验,学习递归自提升智能体的评测思路与工程实现。
五、使用方法
1.环境准备
Python 3.11;安装 uv;本地启动 Docker;准备对应大模型API密钥。
2.项目拉取与安装
git clone https://github.com/Gen‑Verse/PAST‑Bench
cd PAST‑Bench
uv venv
uv pip install -e .
3.环境校验
past-bench doctor
past-bench validate-agent
命令用于校验依赖、沙箱、智能体配置是否正常。
4.冒烟测试(单任务快速验证)
选定 Hermes+ 智能体,指定模型,自动执行开启/关闭持久存储两组对照实验,结果与trace日志输出至traces目录。
5.批量实验
scripts目录提供现成脚本,可以执行:
固定智能体,遍历多款大模型做对比;
固定基座模型,对比不同智能体实现;
Hermes+五大模块消融实验,关闭部分组件观察分数变化。
注意:API密钥不要提交到版本仓库,日志、缓存文件同样不要纳入git提交。
六、竞品对比
| 项目名称 | 核心定位 | 评测形式 | 侧重能力 | 是否支持持久记忆对照实验 |
|---|---|---|---|---|
| PAST‑Bench | 个人智能体递归自提升评测基准 | 有序任务序列+开关对照实验 | 跨会话记忆、经验复用、知识更新 | ✅原生支持,可计算经验净增益 |
| AgentBench | 通用大模型智能体能力评测 | 独立单轮任务 | 工具调用、网页浏览、多工具组合 | ❌无持久记忆对照机制 |
| LongBench | 长文本理解评测 | 长文档问答摘要 | 上下文窗口长文本处理 | ❌只处理单次输入长文本,不模拟跨会话迭代 |
七、常见问题解答
PAST‑Bench可以直接拿来做线上产品的自动化测试吗?
不适合直接用于线上产品自动化测试。它是面向研究场景的基准,依赖Docker沙箱、外部大模型API,目标是做算法对比与论文实验,并非面向业务回归测试工具。
没有Docker环境,能不能运行PAST‑Bench?
无法完整运行全部任务。部分任务依赖沙箱mock services做工具调用模拟,缺少Docker会导致任务执行失败,官方要求运行环境必须具备Docker。
可以接入自定义大模型吗?
可以。需要按照项目模型适配层规范,实现模型调用接口封装,在config配置文件注册模型信息,即可接入自定义基座。
得分高就代表智能体真实具备递归自提升能力吗?
不一定。PAST‑Bench会输出trace日志,需要对照日志判断分数提升来自记忆复用,还是模型随机输出波动,不能只看最终得分数字。
数据集可以单独剥离出来使用吗?
数据集文件存放在self‑evolve‑tasks‑v2目录,可以单独读取任务json数据,但是完整打分逻辑、对照实验逻辑依赖整个框架,直接拿数据集无法复现完整评测。
Hermes+是必须使用的智能体吗?
不是。PAST‑Bench只是附带Hermes+实现,你可以接入其他自研或第三方智能体框架进行评测。
八、相关链接
GitHub仓库:https://github.com/Gen‑Verse/PAST‑Bench
论文arXiv地址:https://arxiv.org/abs/2608.04003
九、总结
PAST‑Bench 填补了长期个人智能体递归自提升方向标准化评测的空白,通过序列式任务与持久存储对照实验,将跨会话记忆复用、流程复用、知识更新这些难以量化的能力转化为可复现的指标,同时提供完整数据集、运行框架、多智能体接入与消融实验工具链,为科研人员与开发者评估、对比、优化记忆增强型AI智能体提供了一套完整可用的开源解决方案。
版权及免责申明:本文由@人工智能研究所原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/past-bench.html