PixelRAG:伯克利开源的视觉检索增强生成框架
一、PixelRAG是什么
PixelRAG是由加州大学伯克利SkyLab、BAIR、Berkeley NLP团队联合开源的视觉RAG(Visual‑RAG)框架,核心思路以网页、PDF截图像素图像作为检索载体,项目口号为Web Screenshots Beat Text。
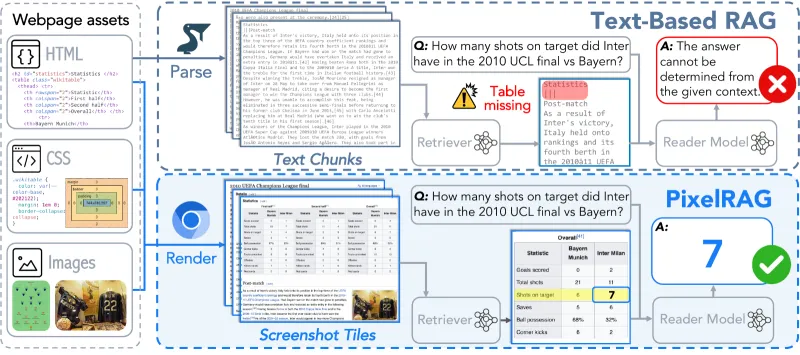
传统RAG大多提取文档纯文本做分块与向量检索,在面对表格、图表、多栏排版、公式时容易丢失关键布局信息,造成检索失效。PixelRAG不依赖OCR提取文本,直接将文档渲染成截图切片,使用视觉嵌入模型完成向量检索,完整保留原始排版结构,解决复杂文档信息丢失问题,配套发布学术论文《PIXELRAG: Web Screenshots Beat Text for Retrieval‑Augmented Generation》,开源协议为Apache‑2.0,2026年6月正式对外开源,提供托管演示站点、公开无密钥API,附带828万维基百科预构建视觉索引库。
二、功能特色
像素级文档检索:直接使用截图切片做检索,完整保留表格、图表、多栏排版、公式,规避OCR文本解析带来的信息丢失。
模块化按需安装:框架组件解耦,渲染、嵌入、索引构建、服务部署、模型训练可独立安装,不需要一次性安装全部依赖,降低环境部署成本。
多源文档兼容:支持网页链接、本地PDF、本地图片批量处理,内置
pixelshot渲染工具,自动适配不同操作系统浏览器内核。双向量数据库后端:原生支持FAISS轻量本地部署,同时兼容Qdrant,支持量化压缩、磁盘存储、分布式服务,适配小体量测试与大规模生产环境。
可溯源答案输出:检索结果附带原始截图资源,回答结果可以定位到页面具体视觉区域,方便人工核对校验答案来源。
配套Claude插件pixelbrowse:为Claude Code提供网页截图浏览能力,通过
/screenshot指令完成页面渲染,无需额外部署后端服务。多查询输入模式:支持文本提问、图片提问两种检索输入方式,预构建大规模维基百科视觉索引,开箱即可体验检索能力。
跨平台运行支持:支持Linux(CUDA)、macOS(MPS苹果硅芯片)、普通CPU环境运行,不强制要求高性能GPU硬件。
三、技术细节
整体工作链路
完整流程分为渲染切片→视觉嵌入生成→向量索引构建→视觉检索→多模态模型问答五大环节。
渲染切片环节:依靠Playwright与Chromium CDP驱动,把网页、PDF渲染为截图Tile切片,独立CLI工具
pixelshot负责该流程,自动调用系统浏览器,PDF文档支持批量分页渲染。视觉嵌入:底层使用经过截图数据集LoRA微调后的Qwen3‑VL‑Embedding‑2B视觉嵌入模型,把截图图像转换成高维语义向量,不经过OCR文本提取步骤,直接基于像素特征编码语义信息。
索引构建:将视觉向量存入向量库,FAISS适合单机本地快速验证;Qdrant用于大规模私有化知识库,支持向量量化、磁盘存储、多实例共享索引。官方预发布217GB维基百科FAISS索引,包含828万维基页面视觉切片数据。
检索推理:用户输入文本或图片查询,生成查询向量,在索引库内做向量相似度匹配,召回Top‑N相关截图切片,将截图送入多模态大模型完成问答输出。
训练模块:项目内置独立uv管理的训练目录,开放LoRA微调流水线、训练数据集,开发者可以基于此对视觉嵌入底座做自定义领域微调适配。
项目工程结构
项目主体使用Python开发,代码目录划分为渲染模块、嵌入模块、索引流水线、HTTP服务、训练脚本、插件、测试套件;提供Colab Demo、完整API文档、CI自动化校验、版本管理体系。
四、应用场景
学术论文知识库问答:解析包含公式、实验图表、对比表格的PDF论文,解决传统RAG丢失图表数据导致回答错误的问题。
企业内部复杂文档检索:处理报表、流程图、多栏合同文档,完整保留原始排版,用于内部知识库、法务文档、金融报表查询。
AI智能体网页浏览增强:对接Claude Code等AI Agent,实现网页表格、图表读取,弥补智能体网页浏览模块对复杂页面解析不足的短板。
百科公开资料检索:调用官方预构建维基百科视觉索引,实现大规模百科知识问答。
私有化文档部署场景:企业内网PDF、本地网页文档,搭建离线视觉RAG知识库,全部数据本地处理,保障数据安全。
五、使用方法
项目提供3套使用方案,从快速体验到私有化部署全覆盖。
方案1:托管公开API,零部署快速测试
无需本地环境、不需要密钥,直接调用公开API接口https://api.pixelrag.ai,调用即可使用828万维基百科预构建视觉索引,适合Demo验证、快速原型测试。
方案2:Python本地安装使用
最小安装,仅安装截图渲染组件
pip install pixelrag
可直接使用pixelshot命令完成网页、PDF截图渲染。
安装嵌入能力
pip install 'pixelrag[embed]'
完整索引构建流水线(渲染+切片+嵌入+建索引)
pip install 'pixelrag[index]'
执行命令完成文档处理:
pixelrag chunk
pixelrag embed
pixelrag build‑index
安装HTTP检索服务
pip install 'pixelrag[serve]'
启动本地检索服务,可选择加载官方预构建维基百科FAISS索引,或者加载自己构建的私有索引。
方案3:完全自建私有知识库
准备本地PDF、网页资源,通过yaml配置文件,执行完整流水线完成私有文档渲染切片、嵌入、构建向量索引,启动本地服务实现离线检索,所有数据保存在本地,不对外传输。
六、竞品对比
选取RAGFlow、传统文本RAG(LlamaIndex文本模式)两个主流方案进行横向对比,从检索载体、复杂表格图表处理、部署模式、向量库、核心短板几个维度对比。
| 对比项 | PixelRAG | RAGFlow | LlamaIndex(传统文本RAG) |
|---|---|---|---|
| 检索载体 | 文档截图视觉像素向量 | OCR解析后的结构化文本 | 纯文本分块 |
| 表格图表处理能力 | ⭐⭐⭐⭐⭐,原生读图,完整保留排版 | ⭐⭐⭐⭐,依靠OCR+文档布局解析,复杂多栏易出错 | ⭐⭐,文本提取丢失图表排版,表格容易错乱 |
| 底层模型 | Qwen3‑VL‑Embedding‑2B(视觉嵌入) | DeepDoc文档解析模型 | 文本Embedding模型 |
| 部署模式 | API托管、单机本地、私有化离线部署 | WebUI、私有化部署 | 代码库集成,需要自行搭建服务 |
| 向量库支持 | FAISS、Qdrant | Chroma、Milvus等主流向量库 | 兼容几乎全部向量数据库 |
| 核心短板 | 大规模索引磁盘占用大 | 复杂图像图表依赖OCR识别效果 | 图表、多栏、公式文档召回效果差 |
七、常见问题解答
Q:PixelRAG必须要有GPU显卡才可以运行吗?
不需要,项目支持CPU、MPS苹果硅芯片、CUDA显卡多种运行模式,CPU模式可以完成全部功能,只是嵌入与索引构建速度会变慢,大规模知识库构建推荐使用GPU加速。
Q:PixelRAG和普通OCR的RAG本质区别是什么?
普通OCR‑RAG先把图片/PDF识别转换成文字,再拿文本做检索;PixelRAG直接拿截图图像做向量检索,没有OCR转文字步骤,完整保留页面布局、表格行列位置、图表图像信息,避免OCR识别错误丢失信息。
Q:官方的维基百科预构建索引体积多大,可以直接商用吗?
预构建FAISS索引大小217GB,项目开源协议为Apache‑2.0,索引资源需要参考项目仓库说明,遵循原始维基百科数据版权约束。
Q:可以使用自己的PDF、内网文档搭建私有视觉知识库吗?
可以,使用index完整依赖包,配置yaml,运行chunk、embed、build‑index流水线,全部文档本地渲染、本地生成向量,数据不会上传外部服务器,支持内网离线使用。
Q:是否支持替换为其他视觉嵌入模型?
支持,训练目录开放完整LoRA微调流程,开发者可以替换底座视觉模型,针对行业文档做微调,适配垂直领域业务。
Q:Windows系统部署会遇到什么问题?
Windows环境会自动适配系统Chrome浏览器,需要确保本地Chrome正常安装;Linux环境会自动下载无头Chromium,无需手动安装浏览器。
八、相关链接
在线演示站点:pixelrag.ai
九、总结
PixelRAG是一套专门针对表格、图表、多栏排版这类复杂文档场景打造的开源视觉RAG框架,跳出传统RAG依赖文本解析的技术路线,直接使用截图像素完成检索,通过模块化设计兼顾快速测试与私有化离线部署,既提供现成大规模维基百科视觉索引方便开发者快速上手,同时开放完整训练流水线支持行业定制,为复杂非结构化文档的检索增强生成提供一套完整可落地的工程方案。
版权及免责申明:本文由@97ai原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/pixelrag.html