Qwen3.8-Omni-Flash:阿里通义千问推出的原生全模态Agent大模型
一、Qwen3.8-Omni-Flash是什么
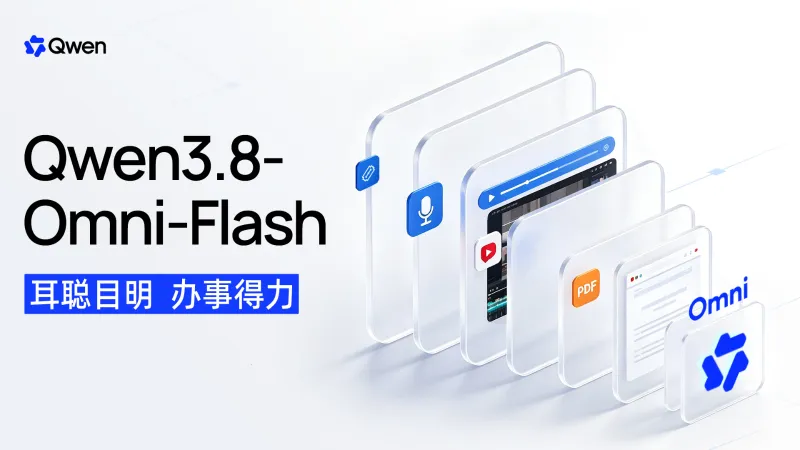
Qwen3.8-Omni-Flash是阿里Qwen团队发布的原生全模态Agent大模型,基于Qwen3.8-Flash-Next架构打造,定位面向生产力场景的全模态智能体。它不再局限于看懂图文音视频内容,而是可以自主完成任务规划、工具调用、内容创作交付,支持文本、图片、音频、视频四类输入,输出为文本内容,依托DashScope千问云平台以云端API形式对外提供服务,暂未开源模型权重,无法本地私有化部署。
二、功能特色
全模态Agent闭环能力
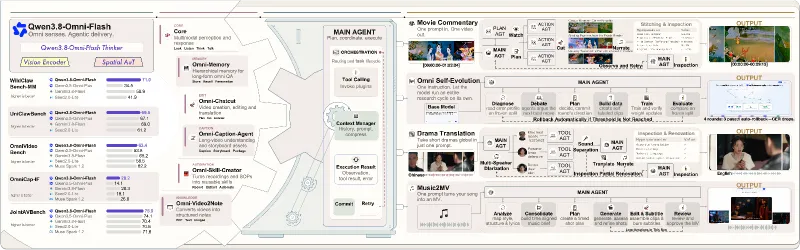
融合文本、图像、音频、视频理解,内置Function Calling工具调用,可自主拆解复杂多媒体任务,完成视频解说文案、会议纪要、MV策划、长视频摘要等端到端工作流,同时保留代码编写、GUI自动化操作、长文档智能处理能力。百万级超长上下文窗口
支持1M Token上下文,能够一次性读取2小时级长视频、多小时会议录音,完整保留全部多媒体素材信息进行综合推理分析。按需感知机制
不会无差别解析视频全部帧与音频全量采样,采用由粗到细的抽取策略,只提取关键画面与声音信息,有效降低Token消耗,减少推理成本。空间音频解析
支持2通道、4通道空间音频识别,实现声源定位、听声辨位,可区分不同方位说话人,适合多声道会议、空间交互场景。多档位推理深度可调
内置reasoning_effort参数,分为xhigh、medium、low三档,可按需调整推理深度,在推理精度、响应速度、调用成本之间灵活取舍,兼容OpenAI标准API协议,接入门槛低,配套Qwen-MM-Plugins插件简化Agent框架集成。成本大幅下降
对比上一代Qwen3.5-Omni-Plus,音频输入单价降幅超98%,音视频综合处理成本降幅超93%,29项综合评测平均分提升超25%,多人会议识别错误率大幅优化。
三、技术细节
底层架构:Qwen3.8-Flash-Next,采用GDN+QSA混合注意力、门控残差、N-gram Embedding、Muon优化器,长上下文预填充速度大幅提升。
上下文规格:总窗口1M Token;最大输入991K Token,最大输出131K Token,推理上限262K Token。
输入类型:文本、图片、音频、视频;输出仅支持文本,音视频文件需要调用外部工具生成。
协议:原生兼容OpenAI Chat Completions、Responses标准API,支持Function Calling、思考模式。
配套组件:Qwen-MM-Plugins多模态插件,简化多媒体Agent开发。
部署形态:云端API服务(DashScope/Model Studio/千问云),权重不开放,不可本地部署。
核心机制:按需感知(选择性抽取音视频关键信息)、空间声视觉融合,多说话人识别与声源定位。
四、应用场景
音视频内容创作:电影/短视频解说文案、MV脚本、视频剪辑策划、长视频笔记提取。
会议与访谈处理:录播会议、访谈音频自动生成字幕、提取纪要、区分不同发言人,输出结构化会议要点。
多媒体内容审核检索:批量音视频素材检索、内容合规筛查、关键信息定位。
全模态智能体开发:搭建音视频对话机器人、多媒体自动化工作流、GUI+音视频联动Agent。
教育与媒体分析:课程录播提炼知识点、影视内容分析、纪录片素材整理。
五、使用方法
平台准备:注册阿里云DashScope(Model Studio)或千问云平台,获取API Key。
模型选择:指定模型ID
qwen3.8-omni-flash。输入构造:支持文本消息、图片链接、音频URL、视频URL,音视频仅支持在用户消息中传入。
参数配置:设置
reasoning_effort选择推理档位,开启Function Calling实现工具调用。调用方式:
兼容OpenAI SDK,替换base_url与api_key即可快速接入;
原生DashScope SDK直接调用多模态对话接口;
配套Qwen-MM-Plugins插件,快速搭建多媒体Agent。
结果获取:模型返回文本结果,如需生成音视频文件,需要额外调用外部媒体工具。
Python最简调用示例(OpenAI兼容协议)
import os
from openai import OpenAI
client = OpenAI(
  api_key=os.getenv("DASHSCOPE_API_KEY"),
  base_url=os.getenv("DASHSCOPE_BASE_URL")
)
resp = client.responses.create(
  model="qwen3.8-omni-flash",
  input=[{"role":"user","content":[{"type":"video_url","video_url":{"url":"https://xxx.mp4"}},"请总结这段视频核心内容"}]
)
print(resp.output_text)
六、竞品对比
选取Gemini 3.8 Flash、Qwen3.8-Flash两款模型进行横向对比:
| 项目 | Qwen3.8-Omni-Flash | Gemini 3.8 Flash | Qwen3.8-Flash |
|---|---|---|---|
| 核心定位 | 原生全模态Agent模型,音视频为核心生产力 | Google全模态模型,综合多模态推理 | 基础文本+图文模型,强代码与长文本Agent |
| 输入支持 | 文本、图片、音频、视频 | 文本、图片、音频、视频 | 文本、图片,无原生音视频输入 |
| 上下文窗口 | 1M Token | 128K Token | 1M Token |
| 特色能力 | 空间音频解析、按需感知、音频成本极低 | 综合视频推理、实时多模态交互 | 代码、GUI自动化、长文档处理 |
| 部署方式 | 仅云端API,权重未开源 | 云端API,部分轻量化版本可本地 | 云端API,支持开源权重本地部署 |
| 优势领域 | 音频理解、多说话人识别、音视频Agent任务 | 纯视频推理、实时多模态对话 | 代码工程、长文本自动化、GUI智能体 |
说明:评测数据均来自厂商发布资料,第三方独立评测待补充。
七、常见问题解答
Q:Qwen3.8-Omni-Flash可以本地部署吗?
A:不可以。该模型发布时没有开放权重,只能通过DashScope、千问云等官方云端API调用,无法下载模型文件私有化本地部署。
Q:模型能不能直接输出视频、音频文件?
A:不能。模型输出只有文本,仅能理解音视频内容,生成文案、摘要、指令;如果需要生成音视频文件,需要调用外部音视频生成工具完成。
Q:Qwen3.8-Omni-Flash和Qwen3.8-Flash的区别是什么?
A:Qwen3.8-Flash是基础底座模型,擅长文本、图片、代码、GUI操作,不原生支持音频、视频输入。Qwen3.8-Omni-Flash是在同架构基础上增强的全模态版本,新增原生音频视频解析、空间音频能力,专门面向音视频类Agent生产力场景。
Q:支持哪些协议接入开发?
A:支持标准OpenAI Chat Completions与Responses API,同时支持原生DashScope SDK,Java、Python等主流开发语言均可快速接入,配套Qwen-MM-Plugins插件简化Agent开发。
Q:音视频输入有文件时长、分辨率限制吗?
A:有,API存在单条音视频文件的时长、分辨率上限,超长音视频需要做分段处理,具体限制以DashScope官方文档为准。
八、相关链接
Qwen官方博客发布页:https://qwen.ai/blog?id=qwen3.8-omni-flash
九、总结
Qwen3.8-Omni-Flash是阿里Qwen面向多媒体生产力场景推出的原生全模态智能体大模型,依托1M超长上下文窗口与Qwen3.8-Flash-Next架构,在文本、图像、音频、视频多模态理解基础上强化任务规划与工具调用闭环,新增空间音频声源定位与按需感知技术,大幅降低音频与音视频API调用成本,适合开发音视频摘要、会议纪要、多媒体智能体等应用,目前仅提供云端API服务,不开放本地权重。
版权及免责申明:本文由@人工智能研究所原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/qwen3-8-omni-flash.html