SemIf:OpenJev开源复现项目,本地离线LLM选项打分实验框架
SemIf是什么
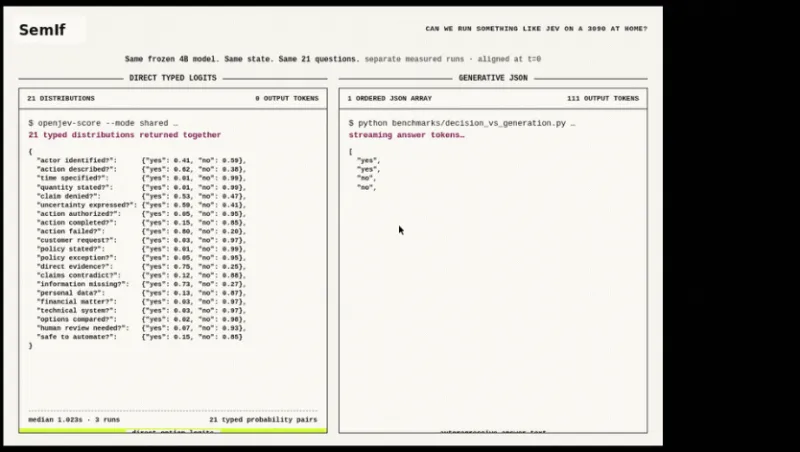
SemIf(原项目名称OpenJev)是一款开源AI决策打分框架,项目托管于GitHub。该项目不提供自研大模型基座权重,依托现有开源大语言模型(Qwen、MiniCPM5等),不做模型微调,直接读取模型推理时产生的token logits概率,对给定候选选项进行打分,输出结构化概率分布结果。
SemIf核心思路区别于常规LLM文本生成模式,不再让模型自由续写文字,而是把任务限定为多选决策,基于原始概率做计算与温度校准,同时支持上下文前缀复用,减少重复推理带来的算力开销,是Jev方案的开源复现实验项目。
功能特色
Logits原生打分,无需微调:直接调用底层token概率计算选项得分,不用对大模型做SFT、LoRA微调,接入现有开源模型即可快速启用。
上下文前缀复用:相同上下文场景下共享前缀推理结果,避免重复计算,降低推理耗时与GPU算力消耗。
温度参数校准:内置温度校准模块,针对决策任务优化概率分布,提升选项判断稳定性;校准参数和任务强绑定,跨场景需要重新调参。
结构化输出:输出标准化JSONL格式结果,包含每个候选选项对应的概率分值,方便后续程序读取、统计与评测。
轻量化部署:支持本地GPU推理,配套网页端在线演示,可在浏览器本地加载模型完成决策打分,无需远端API调用。
专注多选决策任务:原生适配TypeSafe类评测数据集,面向固定候选选项的判断类任务。
技术细节
SemIf底层基于Hugging Face Transformers库完成大模型加载与推理。
常规大模型对话是next-token预测,逐词生成文本;SemIf会拦截模型原始logits输出,把每个候选选项映射为token序列,通过概率求和计算每个选项的原始得分。
再通过温度缩放对原始概率分布做校准,修正LLM原生概率偏差,得到归一化后的选项概率。
上下文缓存机制:当多条样本共享相同前置上下文时,只计算一次前缀KV缓存,后续样本直接复用KV,显著减少token重复推理。
输入格式采用JSONL文件,每条样本包含问题描述与候选选项列表;输出同样为JSONL,记录各选项打分结果。
重要说明:本项目仅为Jev方案的开源实验复现,无法完全复刻官方Jev的精度与全部校准能力。
应用场景
AI模型评测:多选式基准数据集自动化评测,批量计算模型在选择题、判断题任务上的选择概率。
智能决策辅助:知识库问答多选场景、分类选项判断,输出各方案置信度,而非单一文本答案。
模型行为研究:探究大模型原生token概率分布,用于LLM概率校准、模型幻觉相关实验。
本地离线决策服务:内网环境,不调用第三方大模型API,本地部署开源模型做选项打分。
教学与科研实验:高校、开发者学习Logits概率读取、KV缓存复用、LLM决策校准相关原理。
使用方法
1. 代码拉取
git clone https://github.com/TheoLeeCJ/SemIf-OpenJev.git
cd SemIf-OpenJev
2. 环境准备
创建Python虚拟环境并安装依赖
python -m venv .venv
source .venv/bin/activate
pip install -e '.[test]'
Windows PowerShell激活虚拟环境命令:
python -m venv .venv
.venvScriptsActivate.ps1
pip install -e '.[test]'
3. 执行打分任务
CUDA_VISIBLE_DEVICES=0 semif-score
 --mode direct
 --model Qwen/Qwen3.5‑4B
 --input examples/decisions.jsonl
 --output results.jsonl
参数说明:
--mode direct:启用直接logits打分模式--model:指定HuggingFace开源模型名称,首次运行自动下载权重--input:输入JSONL样本文件路径--output:打分结果输出文件路径
竞品对比
| 项目 | 核心原理 | 是否需要微调 | 适用场景 | 核心差异 |
|---|---|---|---|---|
| SemIf | 读取LLM原生logits做选项概率打分,温度校准 | 不需要 | 多选决策、模型评测、概率实验 | 专注选项概率输出,不生成自由文本,支持KV前缀复用,本地部署 |
| OpenAI Eval | 调用LLM API,基于文本生成结果做评测打分 | 不需要 | 通用模型评测,云端API调用 | 依赖外部API,无法获取底层logits,不支持本地离线概率校准 |
| lm-evaluation-harness | 基于模型生成或多选择损失计算评测指标 | 可选 | 大规模LLM基准测试,通用任务评测 | 功能全面,但没有内置温度校准模块,没有专门针对决策任务的前缀缓存优化 |
常见问题解答
问:SemIf自带大模型权重吗?
答:SemIf项目本身不包含任何大模型基座权重,使用时必须指定Hugging Face上已有的开源大模型,例如Qwen、MiniCPM5等,模型权重会在首次运行时自动下载。
问:温度校准参数可以直接复用在不同任务上吗?
答:不可以。温度校准参数和当前任务、数据集强绑定,更换问题类型、候选选项集合之后,需要重新执行校准流程,直接复用旧参数会造成概率结果失真。
问:SemIf和原版Jev的效果完全一致吗?
答:SemIf属于Jev方案的开源实验复现项目,仅复现核心原理,无法达到原版Jev全部精度与完整校准能力,仅适合学习研究、实验场景,不可以直接等同于原版Jev。
问:是否支持CPU运行?
答:支持CPU运行,但推理速度很慢,推荐搭配NVIDIA GPU环境,启用CUDA加速,保证打分任务效率。
问:输出的JSONL文件包含哪些内容?
答:输出文件会保存每条输入样本对应的各个候选选项名称、原始logits得分、经过温度校准后的归一化概率值,方便后续做数据分析。
相关链接
GitHub仓库地址:https://github.com/TheoLeeCJ/SemIf-OpenJev
在线演示网页:https://openjev.com/
总结
SemIf是面向多选决策场景的开源LLM概率打分框架,无需微调现有开源大模型,依靠读取底层token logits完成候选选项概率评估,搭配KV前缀复用与温度校准机制降低推理开销、优化概率分布,项目附带本地推理工具与网页演示,适合开发者、科研人员开展大模型决策行为研究与自动化多选评测,是一套轻量可本地部署的实验型决策工具。
版权及免责申明:本文由@AI工具集原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/semif.html