TalkLikeYou:中科院开源的AI数字人生成模型
一、TalkLikeYou是什么
TalkLikeYou 是中科院自动化所、国科大团队开源的实时说话头像生成项目,论文全称《Talk Like You: Imitating How You Speak in Real-Time Talking Head Generation》。该项目和传统唇同步数字人不同,不只是实现音频对口型,核心目标是复刻目标人物独有的说话习惯、面部细微动作,生成带有个人风格的实时人脸说话视频,支持真人肖像、卡通人像两种输入素材。项目基于Flow Matching框架,单步采样完成推理,实现流式实时生成。
二、功能特色
个性化说话风格复刻:可上传一段人物参考视频,提取这个人专属面部运动特征,同样音频输入下,生成的口部微动作、面部神态会贴合参考人物,避免千篇一律的标准化数字人脸。
单步实时推理:采用Flow Matching生成器,不需要多步迭代采样,推理速度高,支持流式实时Demo,满足低延迟交互场景。
两阶段模仿学习:分阶段训练学习不同人的面部说话表征,区分发音对应的基础口型和个人独有的说话习惯,提升跨人物风格迁移稳定性。
PLAD专属评价指标:提出PLAD指标,把嘴部运动投影到发音特征轴,专门量化个人说话习惯模仿准确度,弥补传统唇同步指标只能判断口型对齐、无法衡量风格相似度的短板。
多类型人像兼容:普通真人照片、卡通风格人像都可以作为底图,驱动生成说话头像视频。
三、技术细节
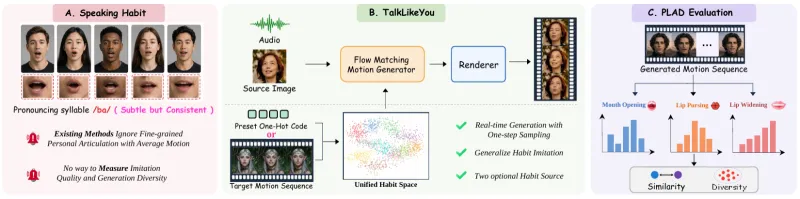
TalkLikeYou整体分为面部运动生成模块与图像渲染模块两大模块。
运动生成:基于Flow Matching构建面部运动生成器,输入音频特征+参考视频提取的个人说话习惯表征,单步采样直接输出完整面部运动序列,省去扩散模型多轮迭代,大幅降低推理延迟,实现实时生成。
两阶段模仿学习策略:第一阶段学习通用音频-面部运动基础映射,保证基础唇形对齐;第二阶段学习不同人物之间说话风格差异,将每个人独特的面部微动作编码到独立表征空间,实现“保留发音对口型,同时复刻个人说话习惯”。
评价指标PLAD:将嘴部运动投影到发音相关特征坐标轴,量化生成结果和参考人物说话行为之间的相似度,用来评估模仿效果与生成多样性。
渲染模块:接收预测出来的面部运动序列,作用于输入人像,渲染输出最终的说话头像视频帧。
四、应用场景
个性化数字人播报:企业宣传片、短视频口播,让数字人保留原型人物的说话神态,提升真实感。
实时虚拟主播交互:低延迟流式生成,用于虚拟人直播、在线对话数字人。
教育与虚拟讲师:复刻讲师说话习惯,制作线上课程虚拟人像。
短视频二次配音:给静态人像换配音,保留人物原本说话风格。
虚拟形象创作:卡通IP形象驱动,为卡通角色赋予专属说话动作。
五、使用方法
环境准备:准备支持CUDA的GPU环境,安装Python、PyTorch、FFmpeg等依赖库,拉取GitHub项目源码。
素材准备:准备基础人像图片,以及一段目标人物的参考短视频,用来提取专属说话风格特征。
音频输入:准备需要驱动人脸的音频文件,支持TTS合成语音或者录制真人音频。
模型推理:加载预训练权重,输入人像图片、参考视频、音频,模型提取参考人物说话表征,实时生成带个性化面部动作的说话头像视频。
Demo在线体验:访问项目Hugging Face在线Demo页面,无需本地部署,直接上传素材快速预览效果。
六、竞品对比
选取SadTalker、Wav2Lip两个经典开源说话头项目进行横向对比。
| 项目名称 | 核心侧重点 | 实时推理能力 | 个性化说话风格复刻 | 特点简述 |
|---|---|---|---|---|
| TalkLikeYou | 复刻人物独有的说话习惯+唇同步 | 支持实时单步推理 | ✅ 支持,核心功能 | Flow Matching单步采样,重点学习人物面部细微说话习惯,使用PLAD指标评估模仿效果 |
| SadTalker | 3D面部运动、表情与头部姿态控制 | 非实时,生成速度较慢 | ❌ 无专属风格建模,生成动作偏通用 | 基于3D系数驱动,口型自然,头部动作丰富,适合短视频数字人制作 |
| Wav2Lip | 高精度唇形对齐 | 原版非实时 | ❌ 仅对口型,没有个人神态建模 | 经典唇同步方案,嘴部对齐精度高,但表情、面部细节较为平淡 |
七、常见问题解答
Q:TalkLikeYou和普通数字人唇同步模型最大差别是什么?
A:传统模型优先保证音频和嘴唇开合对齐,生成的面部动作是通用模板;TalkLikeYou除了基础口型对齐,额外学习每个人独有的细微面部动作习惯,同一段音频,输入不同人物参考视频,生成的神态、嘴部小动作会有明显区分,更像“这个人在说话”。
Q:本地部署TalkLikeYou对显卡有什么要求?
A:项目基于CUDA加速,推荐使用显存10G以上的NVIDIA显卡,显存越小,视频分辨率和实时帧率会相应下降;如果硬件不足,可以优先使用官方Hugging Face在线Demo体验。
Q:参考视频需要多长,有什么要求?
A:参考视频需要目标人物正面人脸,人脸尽量保持清晰,避免大幅度转头遮挡;视频不需要很长,足够提取面部说话运动特征即可,视频质量越高,风格复刻效果越好。
Q:是否支持中文音频驱动生成?
A:项目以音频信号驱动面部运动,不限制语种,中文、英文等各类语言音频都可以输入,音频质量会直接影响最终口型对齐效果。
Q:生成视频会出现身份漂移吗?
A:项目设计中把人像外观和面部运动表征做分离,优先保留原图人物身份;但如果参考视频和底图人像差异过大,极端情况下会出现轻微面部特征偏移,建议参考视频与底图为同一个人。
八、相关链接
项目GitHub仓库:https://github.com/BQ-Wang0511/TalkLikeYou
论文arXiv地址:https://arxiv.org/html/2610.06658v1
九、总结
TalkLikeYou作为开源实时说话头像生成模型,跳出了传统数字人只做唇形对齐的思路,借助Flow Matching单步推理与两阶段模仿学习,实现对人物专属说话神态与面部微动作的复刻,搭配PLAD评价指标量化模仿质量,兼顾生成速度与个性化效果,适合需要高拟真、带个人说话风格的数字人视频与实时虚拟交互场景,为开源音频驱动人脸生成领域提供了新的技术思路。
版权及免责申明:本文由@AI铺子原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/talklikeyou.html