一、EveryInfra是什么
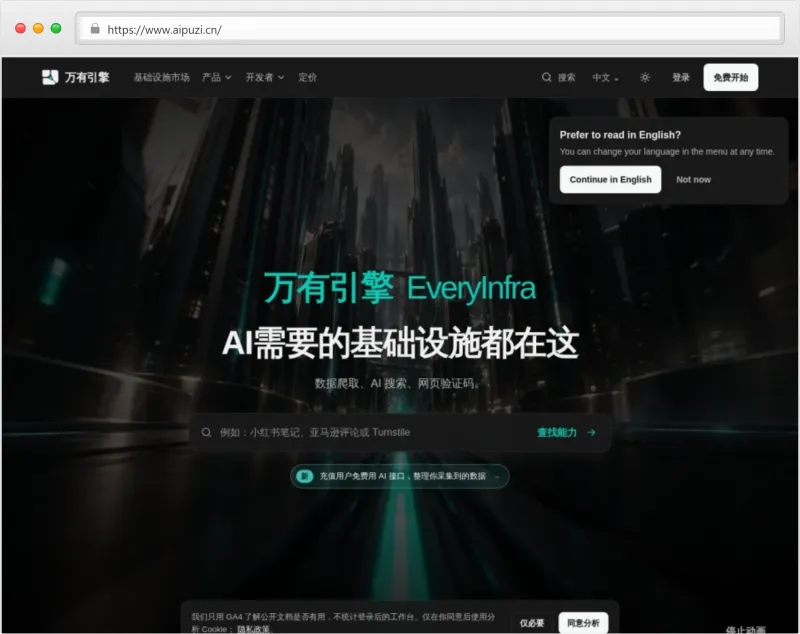
EveryInfra,中文名称万有引擎,是面向AI Agent打造的一站式基础设施平台,平台整合多类网络数据能力,只需要一套API Key,即可调用全部服务。平台主打按成功结果计费,失败请求不扣费,无需固定月订阅,为AI智能体开发、数据调研、自动化信息采集场景提供底层API能力。
平台覆盖社媒、电商、网页检索、验证码识别、数据分析等场景,打通数据采集、网页检索、验证码解析、内容分析整套链路,降低AI Agent开发过程中对接各类第三方接口的开发成本。
温馨提示:使用平台进行数据采集时,需要遵守目标网站robots协议、用户协议以及当地法律法规。
二、产品功能
EveryData 结构化数据爬取
支持90个平台、409项数据能力,覆盖小红书、抖音、TikTok、YouTube、亚马逊、得物、B站、知乎等海内外社交媒体与电商平台。可抓取笔记、评论、商品、账号信息,输出带字段、来源的结构化数据。支持同步、异步任务,支持分页拉取,适合电商选品、社媒内容调研。EverySolve 网页验证码识别
支持53种验证码类型,包含reCAPTCHA、Turnstile、hCaptcha、图形验证码等。仅识别成功才计费,失败不扣款,返回凭证、坐标或文本内容,解决网页访问时的人机验证障碍。EverySearch AI搜索
内置17种检索工具,包含网页检索、正文读取、整站抓取、反向图搜、学术专利检索、交叉验证等能力。搜索结果附带原始来源,方便AI进行事实核对,专门适配大模型、AI Agent的联网检索需求。数据分析Skill工具集
提供现成的数据分析模块,支持电商商品对比、社媒内容表现统计、内容打标、评价正负向痛点挖掘。Skill模块本身不采集数据,需要搭配EveryData使用,分析结果可下载,用于自有AI模型训练与业务分析。
三、产品特色
一站式API体系:一套API Key即可调用数据爬取、验证码识别、AI搜索、数据分析全部能力,不用分别对接多家服务商。
失败不计费:采用按成功结果计费模式,任务失败、空结果会自动退款,减少无效调用带来的成本损耗,无月费门槛。
原生支持MCP协议:提供远程MCP服务,可直接接入支持MCP协议的AI客户端,快速为Agent扩展外部工具能力。
多语言API兼容:REST风格HTTP接口,支持Python、JS/TS、cURL、OpenAPI,开发接入简单。
预制提示词方案:提供预制提示词,可直接给到Claude、ChatGPT、Cursor,AI可以自动完成需求评估、成本确认,生成调用代码。
多客户端兼容:支持Claude Code、GitHub Copilot CLI,可对接Power BI、Snowflake等第三方平台。
四、使用方法
注册账号,获取专属API Key,API Key建议存放于环境变量,禁止硬编码写入业务代码。
选择需要的能力模块:EveryData、EverySolve、EverySearch或数据分析Skill。
接入方式有三类可选:
HTTP API:使用REST接口,支持同步请求;大任务使用异步job轮询模式。
MCP远程服务:地址
https://api.everyinfra.com/mcp,在支持MCP的AI客户端配置该服务地址即可。AI提示词调用:使用平台预制提示词交给大模型,自动生成调用代码。
业务开发建议:先小样本测试,再扩容上线。遇到429、503错误,需要使用退避重试策略;网络异常优先查询job_id,不要重复提交请求;以接口返回
billing/refund字段作为扣费判定依据。
五、适合人群
| 人群类型 | 适用场景描述 |
|---|---|
| AI Agent开发者 | 开发AI智能体,需要联网搜索、外部平台数据获取、验证码绕过能力,快速丰富Agent工具集 |
| 独立开发者/程序员 | 做爬虫、数据调研、行业监控项目,不想维护多套代理、验证码接口,简化项目依赖 |
| 跨境电商运营 | 亚马逊、TikTok等平台商品数据、竞品评价采集,做选品与竞品分析 |
| 新媒体/社媒研究员 | 小红书、抖音、B站、知乎内容、评论数据采集,做内容舆情、爆款分析 |
| 数据分析师/科研人员 | 学术专利检索、网页信息抓取,批量获取公开网页结构化数据用于研究 |
| 中小型技术团队 | 不想自研爬虫与验证码识别底层服务,直接调用API降低研发投入 |
六、竞品对比
| 对比项 | EveryInfra万有引擎 | Tavily | Apify |
|---|---|---|---|
| 产品定位 | 一站式AI Agent基础设施,集合数据采集、验证码识别、AI搜索、数据分析多能力于一体 | 专注AI网页搜索API,面向大模型做网页检索与内容摘要 | 通用爬虫自动化平台,主打爬虫Actor市场,自定义数据抓取工作流 |
| 核心能力 | 社媒电商结构化爬取、验证码识别、AI搜索、数据分析Skill,一套密钥统一调用 | 网页搜索、网页内容提取、内容事实摘要,聚焦联网检索场景 | 自定义爬虫脚本、定时任务、数据存储,海量预制爬虫模板 |
| MCP协议支持 | 原生提供远程MCP服务,直接对接AI Agent客户端 | 不提供MCP原生服务,需要自行封装API调用 | 不原生支持MCP,需要二次开发集成 |
| 能力组合 | 搜索+爬虫+验证码+数据分析一体化,一站式解决Agent外部信息获取全链路 | 仅聚焦搜索信息提取,无验证码、大规模社媒电商采集能力 | 爬虫能力强,搜索、验证码能力需要额外对接第三方服务 |
七、收费价格
EveryInfra采用无月度订阅费,按量付费模式,失败请求、空结果自动退款,不产生费用。
AI搜索:按请求计费;
验证码识别:仅识别成功才扣费;
EveryData数据采集:按结果/请求计费。
平台支持微信、支付宝、银行卡、Apple Pay、USDT、PayNow等多种付款渠道,新用户可添加微信领取体验额度。
八、常见问题解答
Q:EveryInfra可以直接在Claude、Cursor这类AI客户端中使用吗?
A:可以。平台提供MCP远程服务地址,在支持MCP协议的AI客户端配置该服务地址,即可直接调用EveryInfra的全部能力;同时平台也提供预制提示词,交给大模型自动生成调用代码。
Q:API Key在开发时,有哪些安全注意事项?
A:API Key不能直接硬编码写入代码,建议存放至环境变量。如果密钥泄露,他人可使用你的账户额度调用接口,带来不必要消耗。
Q:调用接口返回429、503报错该如何处理?
A:遇到429限流、503服务异常,需要使用退避重试策略。不要无限制重复提交请求,优先查询job_id确认任务状态,避免重复扣费。
Q:所有采集任务失败都会自动退款吗?
A:平台规则为按成功结果计费,任务失败或者返回空结果会自动退款,扣费判定以接口返回billing/refund字段为准。
Q:EveryData采集网页数据,有没有法律相关注意事项?
A:使用EveryData采集第三方平台数据,使用者需要遵守目标网站robots协议、平台用户协议,遵守当地法律法规,不得用于违规爬取、侵权数据采集等行为。
Q:EverySearch支持哪些检索类型?
A:EverySearch内置17种检索工具,包含网页检索、正文读取、整站抓取、反向图搜、学术专利检索、交叉验证,支持AI做事实核验。
九、AI铺子测评
EveryInfra万有引擎是面向AI Agent的一站式基础设施平台,最大优势是多能力整合,将网页搜索、多平台结构化爬虫、验证码识别、数据分析Skill整合在一套API下,同时原生支持MCP协议,适配当前AI智能体开发趋势。
无月费、失败不计费的计费模式,降低了开发者的试错成本,适合独立开发者、AI Agent研发团队、电商与社媒数据调研人员。平台不用开发者分别对接多家服务商,减少接口联调、维护成本。
开发者使用时,依然需要遵守网站协议与法律法规,优先小批量测试,再进行大规模业务调用,保障业务稳定。