Late-interaction嵌入模型实战科普:普通RAG和晚交互检索模型差别在哪
搭建私有RAG知识库的时候,绝大多数人优先关注大模型本身的推理能力。
但很多RAG回答效果差,根源不是对话大模型,而是嵌入模型检索召回不到相关文档。
传统的单向量嵌入方案,会把一整段文本压缩成单个向量,很容易丢失段落细节。
Late-interaction晚交互嵌入模型,是近期RAG领域热门技术路线,pplx-embed-v2-late就是该路线代表性开源模型。本文拆解底层原理,对比传统嵌入方案,给出选型、部署实操建议。
一、什么是Late-interaction(晚交互)嵌入模型
常规嵌入模型工作流程:
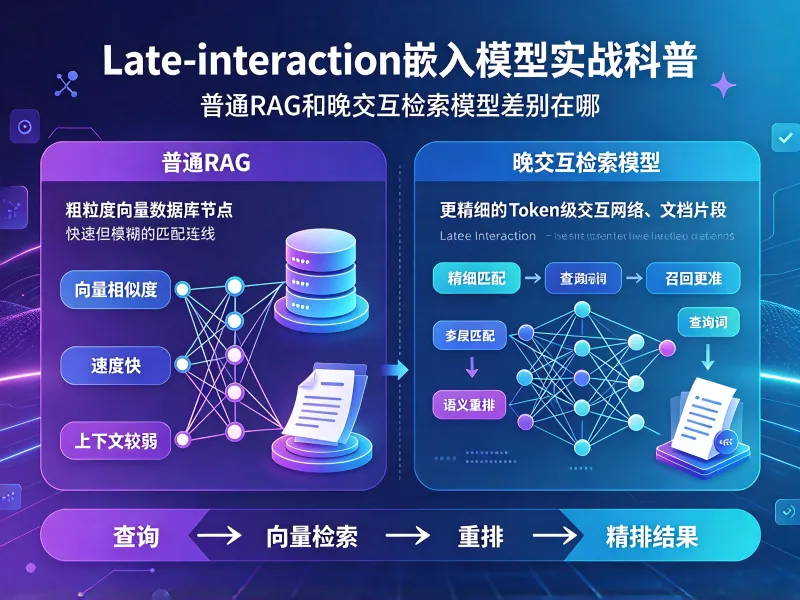
输入一段文本,模型做编码压缩,输出单个向量代表整段文本。检索时,对比查询向量和文档向量相似度,召回topN文档。
这种方式压缩损失大量细粒度信息,长段落里的小众关键词、细节事实很容易丢失。
Late-interaction晚交互模型,不会把文本压缩成单个向量。
模型为文本里每一个token单独生成向量。检索阶段,查询语句的token向量和文档全部token向量做匹配,计算细粒度相似度,最后汇总匹配得分。
交互匹配动作推迟到检索阶段完成,所以命名为“晚交互”。
简单类比:
传统单向量嵌入,相当于读完一篇文章,只写一句摘要,拿摘要对比相似度。
Late-interaction模型,相当于保留文章里每一句话的特征,检索时逐句比对,找到原文匹配片段。
二、传统嵌入模型 vs Late-interaction嵌入模型横向对比
| 对比项目 | 传统单向量嵌入模型 | Late-interaction晚交互嵌入模型 |
|---|---|---|
| 向量输出形式 | 每段文本输出1条向量 | 每一个token输出独立向量 |
| 检索匹配粒度 | 段落级粗匹配 | token级细粒度匹配 |
| 检索精度 | 普通,长文档容易丢失细节 | 更高,适合事实类精准检索 |
| 向量存储占用 | 低,向量数量少 | 高,向量数量随token数量成倍上涨 |
| 查询算力消耗 | 低,向量相似度计算快 | 更高,匹配计算量更大 |
| 索引构建速度 | 快 | 较慢,需要存储全部token向量 |
| 适用场景 | 通用知识库、简单文档问答 | 需要精准事实检索、长文档细节查询 |
| 代表开源模型 | BGE、text-embedding系列 | pplx-embed-v2-late、Jina Late Interaction |
三、Late-interaction模型优势详解
1. 长文档细节检索能力更强
当文档很长,相关信息只藏在段落某一句话时,传统单向量很容易被段落里无关内容干扰。
晚交互模型逐token比对,更容易定位原文内精准片段,减少检索召回失败。
在需要引用原文事实、数据的问答场景,比如合同文档、技术手册、论文知识库,这个优势会明显体现。
2. 大小模型共享向量空间,降低运维成本
pplx-embed-v2-late带来一个很实用的特性,0.6B轻量版和9B旗舰版共享向量空间。
常规嵌入模型,不同版本向量空间不互通。一旦构建向量库用A模型,查询换成B模型,向量完全无法匹配,必须把全部文档重新向量化。
而这套模型,用9B旗舰模型一次性构建完整向量库,后续线上查询改用0.6B小模型,向量库不需要重建。
适合这样的场景:本地算力充足,夜间离线跑全量文档索引;线上服务机器配置偏低,用轻量模型做实时检索,平衡检索质量和服务器开销。
四、Late-interaction模型的短板,部署前必须了解
第一,存储开销显著增加。
1000token的文档,传统模型只存储1条向量;晚交互模型需要存储1000条向量。文档库规模变大之后,向量数据库存储容量会快速上涨。
第二,查询延迟更高。
检索阶段token向量之间的匹配计算量远大于单向量比对。小规模知识库感知不明显,百万级文档库,查询耗时会明显上升。
第三,不是所有RAG场景都需要晚交互模型。
如果知识库都是短文本摘要、简单FAQ问答,普通嵌入模型效果足够,没必要额外承担存储和算力成本。
五、真实场景选型建议
场景1:企业文档库、合同、技术手册,需要精准事实检索
优先考虑Late-interaction嵌入模型,例如pplx-embed-v2-late。
文档内关键数据分散,需要精准定位原文片段,检索精度优先级高于存储成本。
场景2:自媒体素材库、短文笔记库,文档大多是简短段落
继续使用传统单向量嵌入模型,例如BGE系列。
检索需求简单,短文本丢失细节概率低,节省存储与查询算力。
场景3:本地个人知识库,电脑显卡显存有限
推荐方案:离线用9B模型一次性构建向量库;日常查询切换0.6B轻量版本。
一次性完成索引构建,后续日常查询不需要大显存显卡。
场景4:线上高并发RAG服务,用户访问量大
谨慎选用晚交互模型。高并发场景算力成本上涨明显,需要做压力测试,评估服务器承载能力。
六、实操部署注意事项
向量数据库选型要适配海量向量存储。
Late-interaction产生海量token向量,优先选择支持高效向量过滤、分片存储的向量库。轻量本地测试可以用Chroma、Qdrant;大规模生产环境,需要评估Milvus等方案。文档分块策略和传统RAG不一样。
传统RAG分块一般500-1000token。晚交互模型对分块大小敏感度下降,但也不建议使用超大分块。分块过大,单篇文档生成token向量数量爆炸,加剧存储压力。测试时分开评估两个指标:召回准确率、查询耗时。
不要只看检索召回效果,上线前压测查询延迟。部分场景检索精度提升带来的算力开销,业务无法承受。模型许可证核查。
pplx-embed-v2-late采用MIT协议,个人、商业场景都可以使用。但如果搭配其他模型,需要单独核对对应模型开源协议。
FAQ
Q:Late-interaction嵌入模型可以直接替代对话大模型吗?
不可以。嵌入模型只负责文档向量化与检索召回,本身不能生成回答。完整RAG系统,仍然需要搭配LLM,拿到检索文档之后,再交给大模型生成答案。
Q:向量空间共享特性,其他嵌入模型普遍支持吗?
不普遍。绝大多数嵌入模型不同版本之间向量空间不互通,更换模型就要重建向量库。pplx-embed-v2-late这套双版本同向量空间,属于本次发布的特色能力。
Q:本地电脑跑pplx-embed-v2-late,最低显存要求是多少?
0.6B轻量版本,CPU即可运行,不需要显卡;9B旗舰模型做文档向量化,建议16GB显存。批量构建索引,优先使用GPU加速。
Q:Late-interaction检索会提升大模型生成文字的写作质量吗?
只提升检索召回质量。如果检索拿到准确原文片段,大模型引用素材更准确;但模型本身的文笔、推理能力不会发生变化。
总的来说,Late-interaction晚交互嵌入,解决RAG场景长文档细节召回差的痛点,但代价是向量存储与检索算力上涨。pplx-embed-v2-late开源,让个人和开发者低成本体验这套技术。选型核心判断:你的知识库是否对原文细节精准检索有强需求。
版权及免责申明:本文由@AI铺子原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-tutorial/late-interaction-embedding-rag-guide.html