2026年10月大模型横评:Claude Opus 5.5、Gemini 4 Argon、GPT-6 Astra 与 DeepSeek V4.1 Flash 对比
2026 年 10 月的大模型赛道迎来新一轮密集发布潮:Google 时隔七个多月推出旗舰 Gemini 4 Argon,OpenAI 在 10 月 6 日上线 GPT-6 Luna Decisions 决策 API,DeepSeek 凭借 9 月发布的 V4.1 Flash 把中美顶尖模型差距压缩到 3%。面对眼花缭乱的新名字,"谁才是最强模型"这个问题,正在从"一个答案"变成"按场景各取所需"。本文基于 10 月初各权威榜单快照,对当前四家主流厂商的旗舰与主力模型做一次横向测评,并给出可直接落地的选型建议。
一、背景:十月初的发布潮
过去两周,模型市场发生了三件关键的事:
Google 上线 Gemini 4 Argon:以 1525 分登顶 LMSys Text Arena,同时以 1679 分排到 Code Arena(WebDev)第 8 位,定价约为混合每百万 token 8 美元,被视为重塑文本侧 Pareto 前沿的选手。
OpenAI 推出 GPT-6 Luna Decisions:10 月 6 日开放公开测试,这是一个专门返回"结构化决策答案"(predicates、choices、rubric scores)的 typed-answer API,输入输出价低至 $0.1 / $0。
DeepSeek 拉近中美差距:彭博资讯 10 月 5 日报告指出,V4.1 Flash 发布后,中国顶尖模型基准得分与美国对手的差距已从 5 月的约 9%、年初的 15% 收窄到 3%。
二、参测模型一览
| 模型 | 厂商 | 定位 | 输入/输出价(每百万 token) | 上下文 |
|---|---|---|---|---|
| Claude Opus 5.5 | Anthropic | 旗舰全能 | $4 / $20 | 1M |
| Claude Sonnet 5.5 | Anthropic | 高性价比主力 | $2 / $10 | 1M |
| Gemini 4 Argon | 文本/多语旗舰 | 约 $8(混合) | 1M | |
| GPT-6 Astra | OpenAI | 旗舰全能 | $10 / $50 | 1M |
| GPT-6.1 Sol | OpenAI | 性价比推理 | $2 / $10 | 1.1M |
| DeepSeek V4.1 Flash | DeepSeek | 开源高性价比 | 极低 | 1M |
三、分维度测评结果
1. 综合智能:Claude 家族包揽前三
在 Artificial Analysis 的 Intelligence Index(汇总编程、数学、科学、推理、智能体等标准化评测)10 月快照中,Claude Opus 5.5 以 57.6 分登顶,Claude Sonnet 5.5(56.0)与 Claude Fable 5.1(53.4)紧随其后,Anthropic 包揽前三。OpenAI 的 GPT-6 Astra(max)以 53 分排在并列第 5,Gemini 4 Argon(high)同为 53 分。
一句话结论:纯论综合智能,Anthropic 这一代仍是天花板。
2. 编程能力:Opus 5.5 与 Sonnet 5.5 双雄
Arena WebDev 榜:Claude Opus 5.5 以 1815 分排名第 1,比 Sonnet 5.5 高约 15 分;Gemini 4 Argon 以 1679 分排第 8。
Terminal-Bench 4.0:Claude Sonnet 5.5 以 63.6% 领先全场。
LiveBench Coding:Sonnet 5.5 同样处于头部,且价格为 Opus 的一半。
对需要"能干活又不贵"的日常开发,Sonnet 5.5 是当前编程场景的最优解;追求极限复杂任务(大型重构、复杂 agentic 流程)再上 Opus 5.5。
3. 数学与推理:GPT-6 Astra 领跑数学
在 LiveBench 数学类目与部分推理榜单中,GPT-6 Astra(OpenAI)位居第 1,Gemini 4 Argon 在指令遵循、创意写作等多语言任务上表现出色。数学与严格推理场景,OpenAI 与 Google 仍有一战之力,并非 Claude 一家独大。
4. 智能体能力:成本正在颠覆排名
LMSys 的 Agent Arena(能自动完成任务的 AI 助手榜)10 月 3 日快照显示:
GPT-6.1 Sol (Max) 排名第 5,中位任务成本仅 $0.56,重塑了 Pareto 前沿。
Claude Sonnet 5.5 净提升 +12.5%,排名第 3,但单任务中位成本 $2.74,比 Opus 5.5 的 $1.58 高约 73%。
结论:Agent 场景下"最便宜够用"的模型(Sol)正在挤压高价模型的生存空间。
5. 性价比:DeepSeek 与 GPT-6.1 Sol 双低王者
GPT-6.1 Sol:$2 / $10 定价,1.1M 上下文,实测每索引任务约 $0.72,是 OpenAI 家族的价值之选。
DeepSeek V4.1 Flash:在多项任务上以极低价格达到接近旗舰的性能,AI Agent Store 给出的"最佳实用价值"评分为 80.8/100,成为预算敏感型用户与开源爱好者的首选。
四、分场景选型建议
| 你的场景 | 推荐模型 | 理由 |
|---|---|---|
| 复杂长文写作 / 综合知识问答 | Claude Opus 5.5 | 智能指数第一,事实准确性高 |
| 日常编码 / 代码审查 | Claude Sonnet 5.5 | Terminal-Bench 4.0 第一,价格仅为 Opus 一半 |
| 数学 / 严格推理 | GPT-6 Astra | LiveBench Math 领跑 |
| 多语言文本 / 创意写作 | Gemini 4 Argon | Text Arena 第一,多语表现均衡 |
| Agent 自动化任务 | GPT-6.1 Sol | 单任务成本 $0.56,性价比断层领先 |
| 预算有限 / 开源私有化 | DeepSeek V4.1 Flash | 成本极低,性能差距缩至 3% |
| 结构化决策 / 打分场景 | GPT-6 Luna Decisions | 专用 typed-answer API,答案可直接被程序消费 |
五、常见问答解答
Q1:现在最强的 AI 大模型是哪个?
A:综合智能最强的是 Claude Opus 5.5(Intelligence Index 57.6),但不同任务的最优模型不同,建议按场景选择。
Q2:Claude Sonnet 5.5 和 Opus 5.5 怎么选?
A:日常编码与常规任务选 Sonnet 5.5(价格减半、Terminal-Bench 第一);极限复杂任务选 Opus 5.5。
Q3:Gemini 4 Argon 值得用吗?
A:值得。它在 Text Arena 以 1525 分登顶,多语言文本与创意写作表现突出,适合 Google 生态用户。
Q4:DeepSeek V4.1 Flash 和国外旗舰差距大吗?
A:基准差距已收窄至 3% 左右,配合极低价格,是开源与预算敏感场景的高性价比选择。
Q5:GPT-6 Luna Decisions 是什么?
A:OpenAI 10 月 6 日推出的决策专用 API,返回结构化的 predicate / choice / rubric 评分,适合程序化调用。
Q6:Agent 任务用哪个模型最划算?
A:GPT-6.1 Sol 中位任务成本约 $0.56,是目前 Agent 场景性价比断层领先的选择。
六、小结
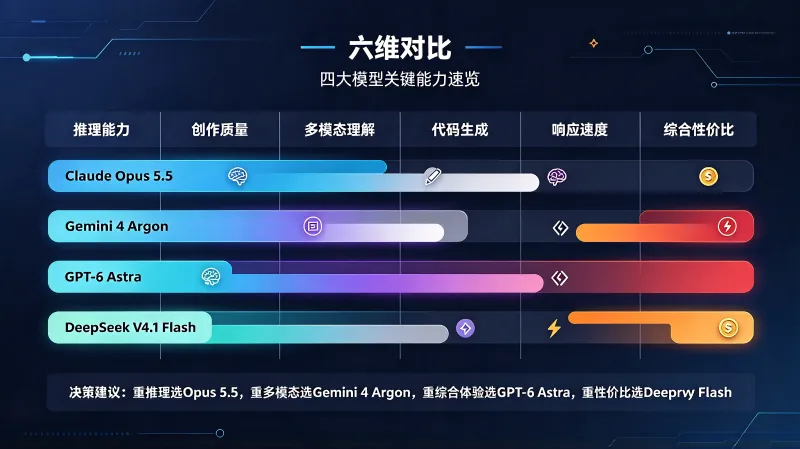
2026 年 10 月的"最强模型"没有唯一答案,只有场景最优解:综合智能看 Claude Opus 5.5,编程性价比看 Claude Sonnet 5.5,数学推理看 GPT-6 Astra,多语文本看 Gemini 4 Argon,Agent 自动化看 GPT-6.1 Sol,预算敏感看 DeepSeek V4.1 Flash。对普通用户来说,按"你要做什么、能花多少钱"两问选型,远比追着榜单第一跑更高效。
版权及免责申明:本文由@AI铺子原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-tutorial/llm-benchmark-october-2026.html