主流开源大模型推理引擎横评:vLLM / TGI / Text Generation WebUI / llama.cpp对比实测
本地私有化部署大模型,推理引擎是决定吞吐量、显存占用、并发能力的核心组件。
市面上开源推理引擎选择很多,面向的人群也完全不同:个人本地把玩、企业高并发API、WebUI可视化交互,各自适配方案不一样。
本文选取四款业界主流开源推理引擎,从底层机制、并发性能、LoRA能力、上手难度、适用场景横向对比实测,帮大家根据硬件和业务选型。
参评项目基础信息
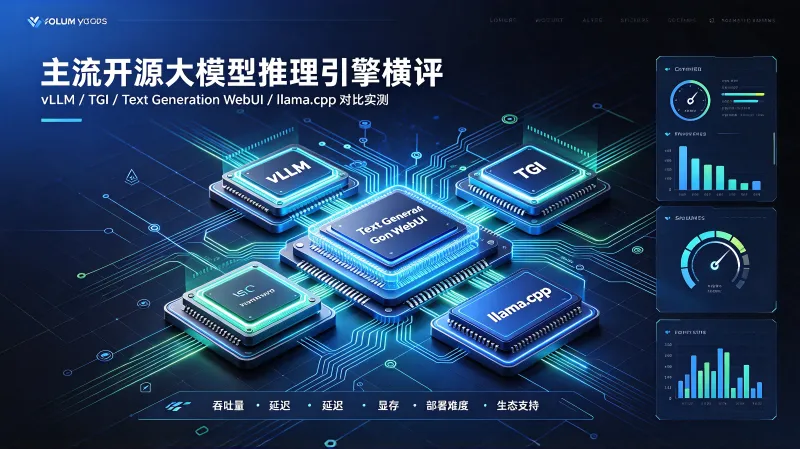
本次横评全部选用真实开源项目。测试硬件:RTX A6000 48G,测试模型:Qwen2.5 7B-Instruct。
测试指标:高并发吞吐、显存优化机制、LoRA支持、热加载能力、是否自带WebUI、上手难度。
| 项目名称 | 高并发吞吐 | 显存优化机制 | LoRA支持 | 热插拔LoRA | 自带WebUI | 上手难度 |
|---|---|---|---|---|---|---|
| vLLM(本次新版) | 优秀 | PagedAttention+前缀缓存 | ✅ | ✅ | ❌ | 偏高 |
| Text-Generation-Inference(TGI) | 良好 | 动态批处理、动态KV缓存 | ✅ | ❌ | ❌ | 偏高 |
| Text Generation WebUI | 一般 | 基础KV缓存 | ✅ | ❌ | ✅ | 低 |
| llama.cpp | 较差 | GGUF量化、KV缓存复用 | 有限 | ❌ | 可选GUI | 很低 |
各项目详细解读
vLLM
vLLM是面向高并发API服务的高性能推理引擎,核心是PagedAttention分页KV缓存机制,本次更新新增前缀缓存共享与LoRA热插拔。
优势:吞吐能力在四款里最强;新版共享前缀缓存,大量用户共用系统提示词场景显存节省明显;LoRA在线热插拔,业务切换适配器不中断服务。
短板:原生不带可视化WebUI,需要额外搭配OpenAI兼容接口前端;配置参数较多,新手学习成本高;对Windows原生支持偏弱,推荐Linux部署。
适合:企业、SaaS平台搭建高并发大模型API服务,多业务LoRA切换场景。
Text-Generation-Inference(TGI)
Hugging Face推出的推理服务框架,主打稳定企业级推理,上一轮更新优化动态批调度。
优势:部署成熟稳定,完善监控指标,支持分布式多卡权重分片,流式输出稳定。
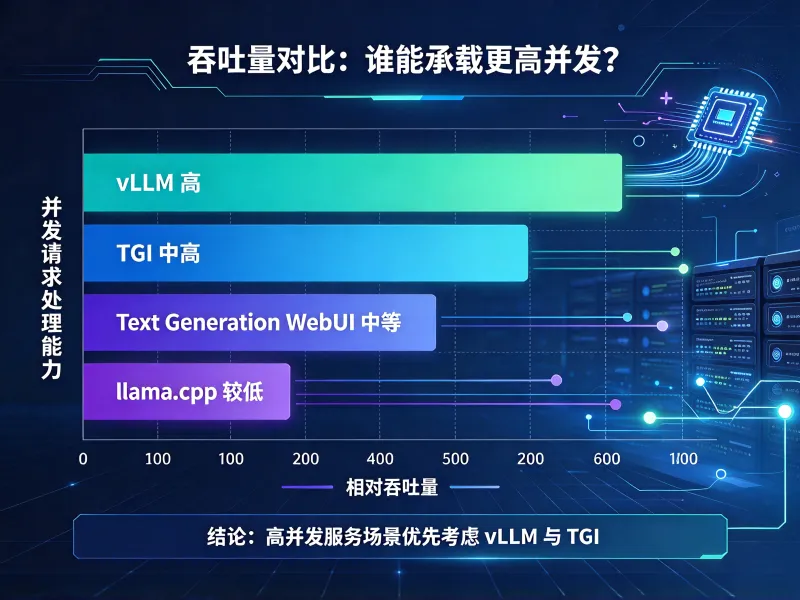
短板:没有LoRA热插拔,更换LoRA需要重启服务;缓存机制不如vLLM先进,高并发场景吞吐低于vLLM。
适合:传统私有化企业内部大模型服务,追求稳定优先,不频繁切换LoRA。
Text Generation WebUI
最普及的个人可视化推理工具,自带完整Web交互界面,插件生态丰富。
优势:开箱即用WebUI,新手友好,一键加载模型、LoRA,支持丰富采样参数调整。
短板:底层推理调度偏向单用户交互,多并发能力弱,不适合对外提供API服务;没有企业级监控能力。
适合:个人本地测试模型、提示词调试、小规模内部演示,不适合高并发线上服务。
llama.cpp
轻量级推理实现,主打GGUF量化模型,CPU/GPU混合推理,跨平台支持最好。
优势:硬件门槛最低,低配电脑也能跑模型;搭配各类GUI客户端(如Cherry Studio)使用;部署简单。
短板:并发能力弱,没有完善的企业级调度;LoRA支持有限,不适合大规模线上推理。
适合:个人本地跑GGUF模型,桌面端AI助手,低算力设备本地推理。
核心概念:前缀缓存与LoRA热插拔
前缀缓存共享原理
很多AI服务会给所有对话固定一段系统提示词,这部分内容每次请求都一样。
前缀缓存把这部分固定prompt的KV缓存计算一次,多个会话共享,不再重复计算,直接节省显存与算力。
限制:只有前缀文本完全一致才能命中共享缓存;用户自定义开头提示词场景收益很小。
LoRA热插拔价值
传统推理引擎加载LoRA,需要加载权重到显存,重启整个推理进程。
业务切换不同领域LoRA,就会造成API服务中断。
vLLM新版LoRA热插拔,在服务运行时加载/卸载适配器,业务无需停机,适合多场景SaaS平台。
代价:同时驻留多个LoRA适配器会占用额外显存,不能无限制加载。
硬件与业务选型建议
个人本地玩模型,单用户为主
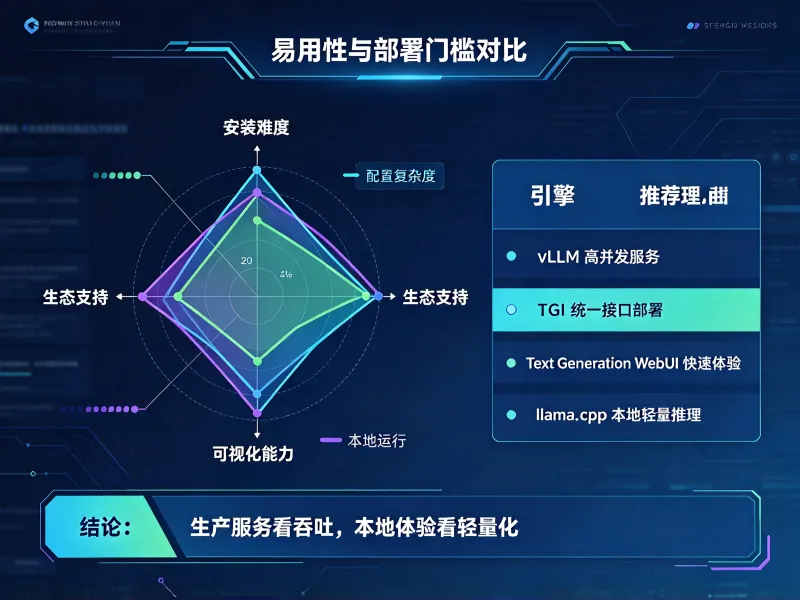
优先选择 Text Generation WebUI 或者 llama.cpp。WebUI可视化操作;llama.cpp搭配GUI客户端,硬件门槛更低。不需要vLLM、TGI这类重型推理引擎,功能过剩。
小团队内部API,少量并发,稳定性优先
推荐TGI,生态成熟,监控完善,部署文档丰富。并发压力不大,不需要vLLM的高性能能力。
高并发SaaS服务,大量用户、共用系统提示词,频繁切换LoRA
首选新版vLLM。前缀缓存降低显存开销,LoRA热插拔实现业务不停机,最大化GPU利用率。
多卡分布式集群部署
vLLM、TGI都支持多卡分片;llama.cpp分布式能力弱,不推荐集群生产环境。
部署避坑要点
前缀缓存共享收益看业务:如果每个用户提示词差异很大,开启前缀缓存几乎没有效果,不用强行开启。
LoRA热插拔,硬盘IO会影响加载速度,存放LoRA权重建议使用SSD,机械硬盘加载延迟明显。
vLLM Windows原生支持有限,生产环境优先Linux;Windows适合仅做测试验证。
推理引擎只是底层,对外提供API务必增加鉴权、限流,不要直接暴露公网。
显存估算要预留余量,KV缓存、LoRA适配器都会占用显存,只按模型权重估算容易OOM。
FAQ
Q:vLLM的前缀缓存,和RAG检索缓存是一回事吗?
A:不是。前缀缓存针对prompt文本的KV推理缓存;RAG缓存是检索向量结果,二者机制完全独立。
Q:LoRA热插拔,能不能加载任意来源LoRA?
A:LoRA需要和基础大模型匹配,基础模型不匹配,加载之后输出会乱码,热插拔只是动态加载,不会自动校验模型匹配度。
Q:vLLM可以搭配Ollama一起使用吗?
A:可以,vLLM提供OpenAI兼容接口,Ollama GUI客户端(Cherry Studio等)可以接入vLLM服务作为模型后端。
Q:llama.cpp可以用于线上对外API服务吗?
A:不推荐。并发调度能力弱,没有完善监控、限流,只适合个人本地使用。
Q:TGI后续会支持LoRA热插拔吗?
A:官方尚未在本次更新中加入该能力,需要关注后续版本迭代。
一句话总结:四款推理引擎定位差异明显。高并发SaaS、多LoRA动态切换选新版vLLM;企业稳定私有化服务选TGI;个人可视化调试选Text Generation WebUI;低配设备本地跑GGUF模型选llama.cpp。
版权及免责申明:本文由@AI工具箱原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-tutorial/llm-inference-engine-vllm-tgi-webui-llamacpp-review.html