Beam:Reflection AI开源的501B混合专家大模型
Beam是什么
Beam 是 Reflection AI 推出的首款采用 Apache 2.0 协议开源权重的稀疏MoE混合专家大语言模型,主打代码编写、复杂逻辑推理与AI智能体(Agent)任务。
模型总参数规模501B,推理时仅激活23B参数,支持最高100万Token超长上下文窗口。该模型依托大规模预训练与超大尺度强化学习训练而成,面向开发者、企业提供高性能、低成本的开源大模型底座,可用于本地部署、Agent开发、代码工程等场景。
功能特色
稀疏MoE高效推理:501B总参,单token仅激活23B参数,大幅降低推理算力开销,兼顾超大模型能力与运行成本。
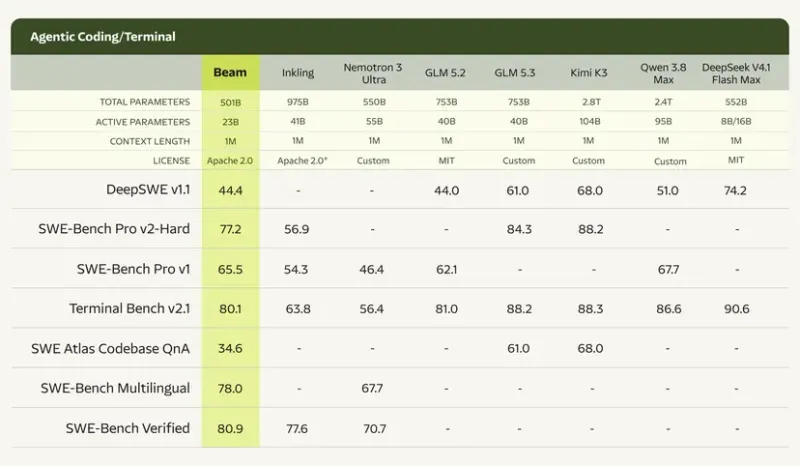
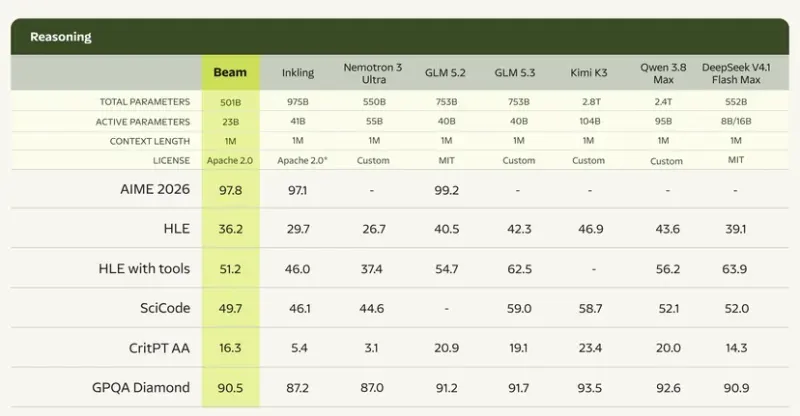
顶尖代码与推理能力:在代码修复、数学推理、终端工具调用基准评测上表现优异,原生适配智能体任务,支持网页浏览、API调用、OCR等分布外任务。
可调推理努力度:可自主控制模型思考深度,简单任务快速输出,高难度数学、工程任务启用更长推理链,灵活平衡响应速度与结果精度。
优秀跨任务泛化能力:仅使用代码、终端、STEM推理数据集做强化学习训练,能力可泛化到未训练过的场景,支持开发网页仪表盘、3D游戏代码、模型微调脚本等。
完善安全对齐体系:采用独立SFT+RL对齐流水线,搭配多教师在策略蒸馏MOPD、审慎对齐方案,降低幻觉、过度拒绝、越狱风险,附带自研安全评测套件。
开源友好协议:Apache 2.0许可,权重、技术报告、模型卡、开发者工具包将对外发布,兼容主流开源大模型运行工作流。
技术细节
模型架构:52层稀疏MoE结构,使用无辅助损失负载均衡+余弦衰减专家偏置更新,训练完成后专家负载均衡度1.04倍;采用深度缩放残差流、SandwichNorm技术保障大模型数值稳定性。上下文窗口最大1M token。
预训练阶段:基于23.8万亿经过去污染处理的高质量Token完成预训练,数据集涵盖网页、开源资料、授权私有数据,重点覆盖代码、STEM学科、技术文档。使用6144张NVIDIA GB300 NVL72 GPU,4周完成预训练,集群有效利用率92.3%。中期训练进一步强化推理、工具调用能力,拓展上下文上限。
大规模强化学习RL:投入10500张NVIDIA GB300 GPU,连续训练4周,生成超1亿次rollout交互样本;构建近百万高质量任务环境,累计消耗约13亿沙盒实例。自研异步策略梯度算法,缓解大尺度异步RL策略陈旧问题,支持11万并发rollout,最高17万并发沙盒环境,模型权重集群分发中位耗时约12秒。
对齐技术:分层对齐目标,包含硬性安全规则、输出质量、交互风格三层目标;通过对抗数据集迭代挖掘越狱提示词,使用MOPD多教师在策略蒸馏融合能力模型与安全模型,抑制有害输出、幻觉与格式冗余问题。
应用场景
AI智能体开发:构建网页浏览、工具调用、自动化运维Agent,执行终端命令、API调用、OCR信息提取,完成复杂链式任务。
软件工程开发:代码生成、代码调试、SWE级bug修复,编写项目脚本、网页仪表盘、3D游戏代码,支撑工程级开发工作。
数学与科学推理:STEM题目求解、复杂逻辑推导、科研文档分析,处理高难度竞赛数学、GPQA类专业知识问题。
企业私有化部署:企业本地部署大模型底座,搭建内部知识库、文档解析系统,依托1M上下文处理超长技术文档。
模型二次微调:基于开源权重做领域微调,开发行业专属模型,编写模型微调Notebook,快速落地垂直场景。
使用方法
申请早期访问:访问Reflection AI官方博客,提交信息加入等待列表,获取模型早期访问权限。
获取模型资源:官方发布后下载模型权重、技术报告、模型卡与配套开发者工具包,遵循Apache2.0协议规范使用。
环境部署:依托兼容MoE大模型的推理框架,配置GPU硬件环境,加载模型,可调节推理努力度参数适配不同任务。
开发与微调:使用配套工具链进行二次开发、领域微调,搭建Agent沙盒环境,接入各类外部工具与API。
安全评测:使用官方开源安全评测套件,完成模型安全、幻觉能力测试,上线前完成风险校验。
竞品对比
| 项目 | Reflection Beam | GLM-5.2 | DeepSeek V4.1 Flash |
|---|---|---|---|
| 模型类型 | 稀疏MoE,501B总参/激活23B | 稀疏MoE | 稠密大模型 |
| 开源协议 | Apache 2.0 | 开源权重 | 开源权重 |
| 最大上下文 | 1M token | 1M token | 128K token |
| 核心优势 | Agent、代码、数学推理,推理算力开销低 | 综合能力均衡,生态完善 | 代码能力突出,推理速度快 |
| 短板 | 暂未正式发布权重,生态处于起步阶段 | 推理计算量更高 | 超长文档处理上限更低 |
| 适合场景 | 私有化Agent、大规模代码推理部署 | 通用企业场景、多任务业务 | 代码专项开发 |
常见问题解答
问:Reflection Beam模型什么时候会正式发布权重?
答:官方计划在2026年10月内放出完整模型权重、技术报告、模型卡与开发者工具包,现阶段可提交申请加入早期访问等待名单。
问:Beam模型的Apache 2.0协议意味着什么?
答:Apache 2.0是宽松开源协议,允许个人与企业免费使用、修改、分发模型权重,可用于商业场景,仅需保留版权声明,没有强制开源衍生作品的约束。
问:Beam推理激活参数只有23B,会不会能力大幅缩水?
答:不会。稀疏MoE架构只有部分专家参与单次token计算,总参501B完整知识能力保留。23B是推理激活参数,目的是降低算力消耗,在代码、数学、Agent任务上仍保持顶尖水准。
问:Beam支持本地部署吗,硬件要求高吗?
答:支持本地私有化部署。作为MoE模型,想要完整运行对GPU显存要求较高;可通过量化技术降低显存占用,适合具备GPU集群的企业与开发者使用。
问:Beam的强化学习训练和普通SFT模型有什么区别?
答:Beam使用超大规模沙盒RL训练,依靠大量交互式试错样本学习工具调用、链式推理;普通SFT只是基于静态数据集学习文本,在Agent动态交互、复杂问题分步解决能力上弱于RL训练的Beam。
问:Beam模型是否支持多模态能力?
答:当前版本Beam为文本大模型,核心聚焦文本推理、代码、Agent工具调用,暂不支持图像、音视频原生多模态输入输出。
相关链接
Reflection AI官网:https://reflection.ai
总结
Reflection Beam 是 Reflection AI 发布的 Apache2.0 开源稀疏MoE大模型,凭借501B总参数、23B激活参数、百万级上下文窗口以及大规模强化学习训练,在代码修复、数学推理、AI智能体任务上具备强大性能,有效降低大模型推理算力成本,配套完整安全对齐方案与开发者工具链,为开发者和企业提供了一款高性能、可私有化部署的开源大模型底座,适合智能体开发、软件工程、科研推理等场景落地。
版权及免责申明:本文由@AI铺子原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/beam.html