MiniCPM5-2B:面壁智能开源2B级端侧文本大模型
一、MiniCPM5-2B是什么
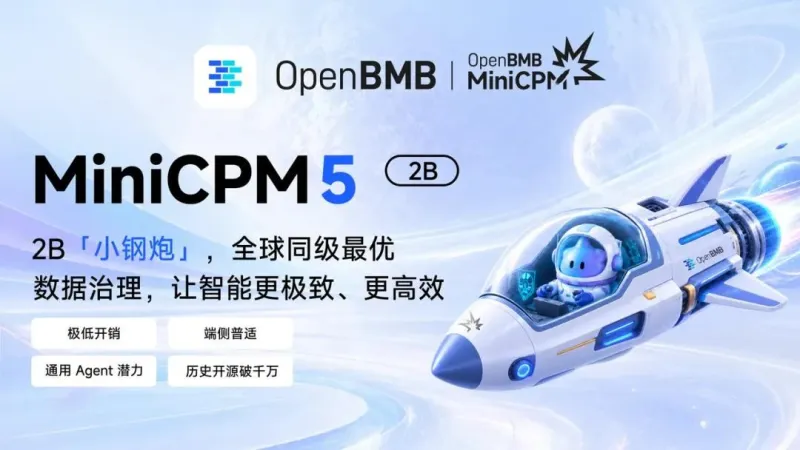
MiniCPM5-2B是面壁智能OpenBMB社区推出的MiniCPM5系列第二款开源稠密文本大模型,于2026年9月7日正式开源,采用Apache 2.0协议,允许个人与商业场景免费使用。
模型名义总参数量25.17亿,剔除Embedding层后有效参数约19.8亿,定位轻量化端侧基座模型。它延续MiniCPM5系列的混合思考设计,原生支持128K超长上下文,内置Agent工具调用能力,在2B参数区间实现越级性能,普通消费级显卡即可本地量化部署。
二、功能特色
混合思考切换 Think / No-Think
同一套模型权重,通过开关enable_thinking切换推理模式。Think模式会内部生成思维链,显著提升数学、代码、复杂推理任务准确率;No-Think模式跳过内部思考过程,输出响应更快,适合日常问答、文本摘要等轻量任务。原生Agent与工具调用能力
模型在训练阶段融入大量Agent指令样本,开箱即可完成多步骤任务、函数调用,同尺寸开源模型中Agent评测指标优势明显,可直接搭建本地私有化智能体。128K超长上下文窗口
原生支持131072 token上下文,能够一次性读取整本长文档、批量代码文件,完成长文本摘要、信息抽取、文档比对。多框架推理与丰富量化方案
原生兼容Transformers、vLLM、SGLang主流推理框架,同步提供GGUF、GPTQ、MLX量化版本,适配PC、嵌入式设备离线运行。配套完整开源训练数据集
同步开放UltraData系列数据集,包含网页预训练数据UltraX、代码数据集UltraData-Code、50万Agent SFT样本、8万+RL数据,开发者可复现模型训练流程。
三、技术细节
模型架构:LlamaForCausalLM,稠密解码器架构
网络层数:42层
注意力机制:GQA分组查询注意力,16个Query头,2个KV头,降低长文本推理显存占用
参数量:总25.17B,去除embedding约19.8B
上下文长度:原生128K token
模态:纯文本大模型,不支持图像输入
开源协议:Apache 2.0
训练配套:UltraData全套训练数据开放
四、应用场景
本地私有化知识库:长文档解析、资料检索、文档问答,数据不出本地设备
端侧本地Agent:本地工具调用、多步骤任务编排、自动化脚本执行
轻量代码助手:代码编写、bug排查、代码解释、脚本生成
数学与逻辑推理:计算题、逻辑题、方案推导,开启Think模式效果更佳
嵌入式/离线设备部署:低算力设备离线文本处理,无网络也可运行
五、使用方法
1. Transformers 基础调用示例
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "openbmb/MiniCPM5-2B"
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
  model_name,
  trust_remote_code=True,
  device_map="auto"
)

prompt = "简单介绍大模型混合思考模式"
messages = [{"role": "user", "content": prompt}]
inputs = tokenizer.apply_chat_template(messages, return_tensors="pt", add_generation_prompt=True).to("cuda")

outputs = model.generate(inputs, max_new_tokens=512, enable_thinking=True)
print(tokenizer.decode(outputs[0][inputs.shape[-1]:], skip_special_tokens=True))
enable_thinking=True开启思维链推理;设置为False为快速直出模式。
2. 量化部署
优先选用GGUF量化文件,通过llama.cpp推理,硬件门槛最低;GPU环境可选用GPTQ量化,搭配vLLM提升吞吐。
最低硬件参考:GGUF 4bit量化版本,8G显存PC可运行;推荐12G及以上显存获得流畅体验。
六、竞品对比
选取同参数量级热门开源模型做对比:
| 模型 | 上下文长度 | 核心特点 | Agent能力 |
|---|---|---|---|
| MiniCPM5-2B | 128K | 混合思考双模式,2.5B稠密基座,Apache2.0 | ⭐⭐⭐⭐⭐原生训练支持 |
| Qwen3.5-2B | 32K | 阿里通义千问,通用问答表现均衡 | ⭐⭐⭐基础支持,需额外微调 |
| LFM2.5-2.6B | 128K | 长文本能力优秀,推理速度快 | ⭐⭐较弱,不适合复杂智能体任务 |
七、常见问题解答
Q:MiniCPM5-2B支持图片输入吗?
A:不支持。MiniCPM5-2B是纯文本大模型,没有视觉编码器,只能处理文本输入,不能识别图片。
Q:商用是否免费?有什么限制?
A:模型采用Apache 2.0开源协议,可免费商用,允许修改、二次分发。仅需要遵守协议版权声明,无额外授权费用。
Q:Think模式会增加推理耗时吗?
A:会。Think模式模型内部会生成隐藏思维链,token输出量变大,推理速度变慢;适合推理类任务,简单问答建议关闭。
Q:本地部署最低需要什么配置?
A:4bit GGUF量化版本,8GB显存设备可以加载运行;如果使用FP16原版权重,需要至少16GB显存。
Q:可以在手机端跑MiniCPM5-2B吗?
A:可以,使用GGUF量化包搭配移动端llama.cpp框架,高端安卓手机能够离线推理,但受手机内存限制,速度会偏慢。
八、相关链接
模型Hugging Face主页:https://huggingface.co/openbmb/MiniCPM5-2B
MiniCPM系列Github仓库:https://github.com/OpenBMB/MiniCPM
UltraData数据集仓库:https://github.com/OpenBMB/UltraData
九、总结
MiniCPM5-2B是面壁智能推出的轻量化2B级开源文本基座模型,依托128K超长上下文、可切换的混合思考机制与原生Agent工具调用能力,在同参数规模模型中取得突出综合性能,搭配全套开放训练数据集与多格式量化权重,能够满足个人开发者、小型项目本地私有化部署、端侧智能体搭建、长文本处理等需求,Apache2.0协议也降低了个人与商业项目落地的门槛。
版权及免责申明:本文由@97ai原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/minicpm5-2b.html