MiniMax M3.1 Flash 正式发布:推理速度提升 3 倍,API 价格下调 70%
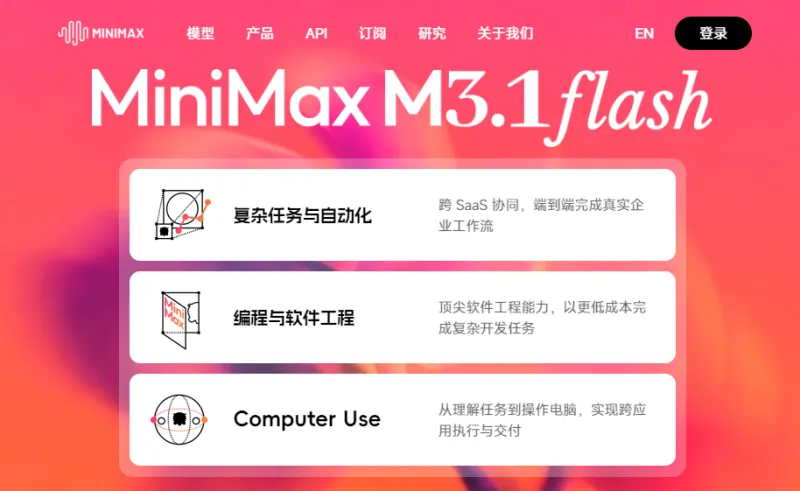
MiniMax在10月19日晚间推出新一代轻量大模型M3.1 Flash,主打高吞吐、低成本,在Agent任务、编程、电脑操作、网络安全方向完成能力升级。
此前WorkBuddy平台上线的匿名模型Space Bunny,就是M3.1 Flash的早期测试版本。
这款模型采用稀疏注意力架构,稳定输出速度中位数170+ TPS,峰值可达200+ TPS,整体推理速度相比前代M3提升接近3倍。
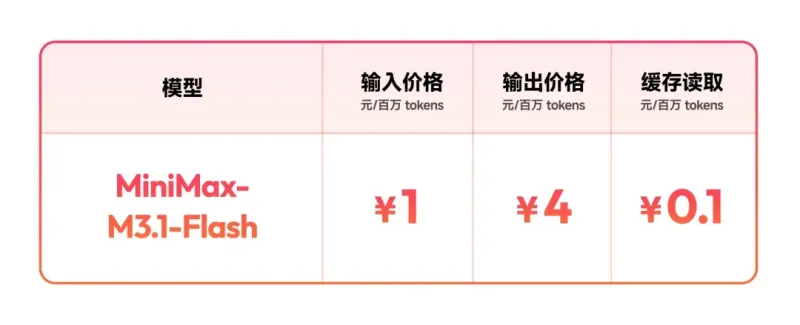
同时官方同步下调API计费标准,输入每百万token 1元,输出每百万token 4元,缓存读取仅0.1元/百万token。
对比M3原版,输入、输出单价降幅超过50%,缓存读取费用下降70%以上。
很多开发者会关心,M3.1 Flash到底适合什么样的场景。
它定位高速轻量推理,优先面向高频、短轮次的Agent自动化任务,比如网页浏览、批量API调用、代码脚本生成。
高吞吐特性意味着单台服务器可以承载更多并发请求,企业搭建自动化智能体集群时,算力开销会明显降低。
普通开发者和独立创业者,是这次更新最大受益群体。
更低的token单价,意味着批量跑Agent任务、自动化测试、代码批量生成的成本大幅压缩。
不需要采购昂贵本地显卡,直接调用API就能跑高并发的自动化流程。
也要客观看待模型定位。M3.1 Flash是Flash高速版本,不是旗舰Pro模型。
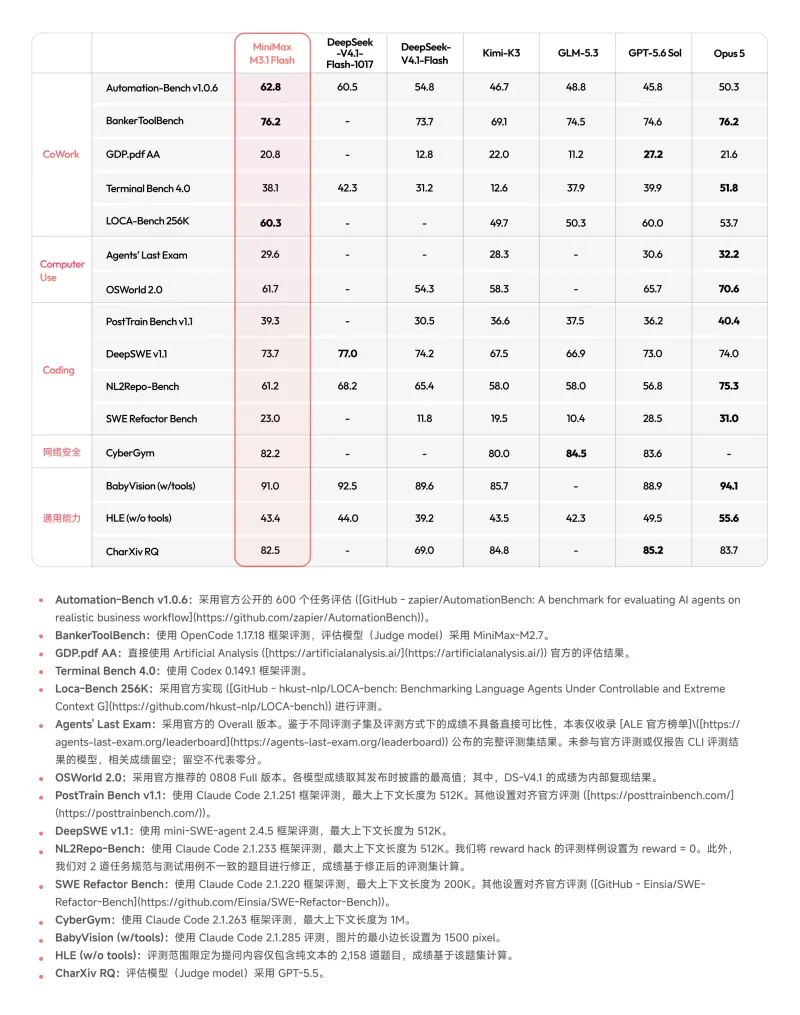
官方预告,更高智能上限的Pro版本会在后续推出,复杂长文本深度推理、多模态重度创作场景,仍然需要等待Pro版本。
M3.1 Flash更适合追求速度与成本平衡的自动化任务,不适合重度长链推理。
整体来看,国内大模型厂商正在持续压缩Agent应用落地成本。
高吞吐+低价API组合,会降低各类AI智能体产品的创业门槛,更多面向办公、网页自动化的小工具会快速涌现。
一句话总结:MiniMax M3.1 Flash主打高速并发,TPS与定价双优化,适合批量Agent自动化、代码生成场景,重度复杂推理任务仍需等待Pro版本。
版权及免责申明:本文由@AI铺子原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/minimax-m31-flash-release.html