Nemotron 3.5 Lightning:英伟达推出的轻量化智能体分层执行模型
一、Nemotron 3.5 Lightning 是什么
Nemotron 3.5 Lightning 是英伟达(NVIDIA)开源发布的混合专家(MoE)轻量化大语言模型,隶属于Nemotron 3模型家族,是该系列定位最低、专为长时运行AI智能体高频执行层打造的专用模型。
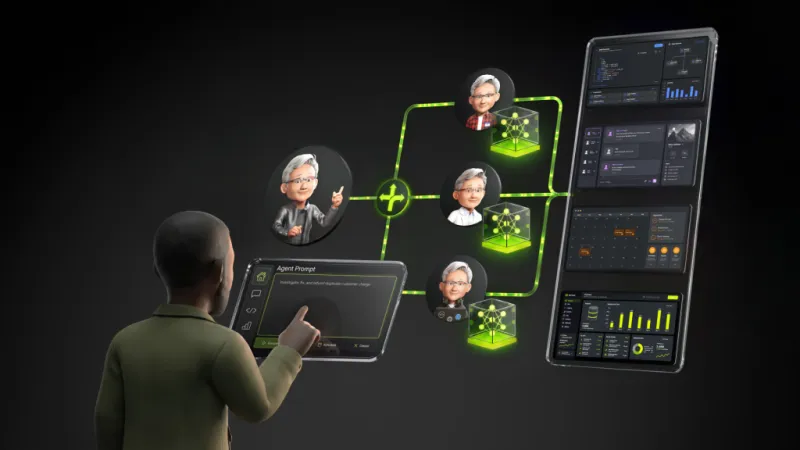
模型基础规格为总参数30B,单次推理仅激活3B参数,核心定位不替代Nemotron 3 Ultra等旗舰推理大模型,而是构建分层多模型AI智能体体系:由Ultra等旗舰模型负责复杂任务规划、全局逻辑调度,Nemotron 3.5 Lightning承接工具调用、结果校验、子智能体委派、数据格式化等海量重复执行工作,解决单一超大模型处理高频任务时延迟高、算力成本昂贵的痛点。
配套开源调度工具NeMo Switchyard,可实现多模型智能路由分流;整体采用OpenMDW-1.1宽松开源协议,完整开放权重、训练数据集、微调全流程配方,支持本地消费级显卡、边缘设备、企业数据中心全场景部署。
二、核心功能特色
智能体执行专项优化
原生针对OpenClaw、Hermes Agent、LangChain等主流智能体框架做定制训练,工具调用准确率更高,大幅降低高频循环任务的推理延迟,适配7×24小时持续运行的自治AI智能体。极速推理,速度领先同级
搭载推测解码、双草稿模型、NVFP4量化三重加速方案,输出生成速度最高达同类尺寸模型4倍;PinchBench智能体基准测试中,同等86%准确率下,完成10000项任务速度比竞品快30%。全硬件兼容本地AI部署
兼容NVIDIA Jetson边缘设备、RTX 5090消费级显卡、DGX Spark工作站、企业级DGX数据中心;支持LM Studio、Ollama、llama.cpp、Unsloth等主流本地推理工具,普通消费显卡即可独立运行。高度自定义微调体系
提供完整开源微调工具链,支持LoRA轻量化微调、全参数SFT监督微调、NeMo RL强化学习、NeMo Gym仿真环境评测;配套专属智能体强化学习数据集Nemotron-RL Agentic Terminal Pivot,低成本完成行业场景适配。配套NeMo Switchyard智能调度
开源模型路由库,自动区分任务难度:复杂推理任务转发至Nemotron 3 Ultra旗舰模型,重复性执行任务下发至Nemotron 3.5 Lightning,混合调度开源、闭源多类模型,优化整体token消耗与算力成本。完整产业生态支持
覆盖后训练、推理软件、智能体框架、云厂商、托管推理服务商全链路合作伙伴,落地无需从零搭建配套工具。
三、底层技术细节
3.1 MoE混合专家稀疏架构
总参数量30B,推理时仅路由激活3B参数;每一段token仅分配给少量领域专家计算,兼顾大模型的知识容量与小模型的算力开销,实现“大模型能力、小模型成本”。
3.2 推测解码(Speculative Decoding)加速体系
预训练阶段原生嵌入多Token预测(MTP),额外增加MTP强化训练阶段,大幅提升批量token生成准确率;
配套两款专用草稿模型:
DSpark:适配DGX Spark、低并发数据中心推理;
DFlash:通用备选草稿模型,适配多样化负载;
并发适配逻辑:中高并发场景优先使用MTP方案,并发量越高最优草稿长度越小。
3.3 双精度量化方案
同步提供BF16标准权重、NVFP4低比特量化权重,适配Blackwell、Hopper、Ampere三代全系NVIDIA GPU;NVFP4专用内核压缩显存占用,推理精度损耗极低,兼顾本地小显卡与大规模集群部署。
3.4 NemoClaw安全运维栈配套
原生适配NemoClaw开源安全管理工具,面向7×24小时长时运行智能体提供权限管控、调用审计、异常拦截能力,满足企业生产环境安全规范。
3.5 训练架构优化
采用Harness-optimized专项训练方案,针对主流智能体框架的工具调用语法、返回格式、校验逻辑做专项拟合,减少工具调用报错、重复重试带来的资源浪费。
四、落地应用场景
企业自治AI智能体执行层
业务流程自动化智能体、代码运维智能体、数据处理机器人:承担git指令调用、接口校验、日志解析、结果格式化等高频循环操作,复杂业务规划交由旗舰大模型处理。本地个人AI助手/桌面智能体
基于RTX 5090等消费显卡搭建离线本地助手,执行文件检索、脚本运行、文档摘要、指令校验等轻量高频任务,无需云端API、无token计费。开发编码辅助智能体
搭配Kilo Code、OpenHands、Cline等代码框架,完成代码片段校验、命令行执行、报错解析、测试用例生成,提升开发智能体吞吐效率。云端多模型混合推理平台
谷歌云、微软Foundry、OCI企业AI等云厂商托管服务,通过NeMo Switchyard实现任务分流,降低云端推理总成本、减少排队延迟。边缘端离线智能设备
NVIDIA Jetson嵌入式设备搭载离线AI智能体,用于工业设备巡检、本地数据采集校验、物联网指令下发,断网环境稳定运行。自动化测试与流程校验系统
批量任务自动化平台,海量重复校验、表单解析、规则匹配等高吞吐场景,提升单位GPU可承载任务总量。
五、分步使用方法
步骤1:模型资源获取(三渠道任选)
在线快速体验:NVIDIA官方平台build.nvidia.com、OpenRouter;
权重下载:Hugging Face、ModelScope开源模型仓库;
配套文档:下载官方Nemotron 3.5 Lightning操作手册。
步骤2:本地单机部署(消费显卡/DGX Spark)
推理引擎选择vLLM、SGLang、TensorRT-LLM、Ollama、LM Studio;
权重选择:本地小显存显卡优先NVFP4量化版本,集群使用BF16版本;
加载DFlash/DSpark草稿模型,开启推测解码提速;
对接LangChain、OpenClaw等智能体框架,配置工具调用模板。
步骤3:微调定制行业模型
使用NeMo Automodel、NeMo Megatron Bridge执行LoRA/全量SFT微调;
导入Nemotron-RL Agentic Terminal Pivot数据集,通过NeMo RL完成强化学习优化;
NeMo Gym搭建仿真环境,批量评测工具调用准确率。
步骤4:多模型调度(NeMo Switchyard)
部署Nemotron 3 Ultra+Nemotron 3.5 Lightning双模型实例;
配置路由规则:复杂推理任务转发Ultra,执行类任务下发Lightning;
接入自有第三方开源/闭源模型,统一调度管理。
步骤5:生产运维
基于NemoClaw开源栈实现智能体权限审计、调用限流、异常告警,适配企业7×24小时持续运行需求。
六、竞品参数性能对比
选取两款主流同定位MoE智能体开源模型Qwen3.6 35B、Llama 3.1 34B(稠密基线)做横向对比,数据全部来源于官方公开基准测试:
| 对比维度 | Nemotron 3.5 Lightning | Qwen3.6 35B-A3B | Llama 3.1 34B(稠密) |
|---|---|---|---|
| 架构类型 | MoE混合专家 | MoE混合专家 | 稠密Decoder-only(无稀疏激活) |
| 总参数/激活参数 | 30B / 3B | 35B / 3B | 34B(全部激活) |
| 智能体基准PinchBench准确率 | 86% | 86% | 81% |
| 同等精度任务完成速度基准 | 基准值(100%) | 慢30% | 慢55% |
| 原生推测解码支持 | 原生内置MTP+双草稿模型 | 仅基础多token生成 | 无原生优化,需第三方插件 |
| 量化方案 | BF16 + NVFP4 | BF16 + FP8 | BF16/FP8,无专用低比特内核 |
| 本地显卡适配 | RTX 5090、Jetson全兼容 | 仅高端RTX 4090+流畅运行 | 显存占用极高,本地部署门槛高 |
| 智能体框架专项训练 | OpenClaw/Hermes/LangChain原生适配 | 通用训练,无智能体专项优化 | 通用对话训练,工具调用能力偏弱 |
| 开源协议 | OpenMDW-1.1宽松商用 | Apache 2.0 | Meta商用授权(有额度限制) |
| 配套调度工具 | 原生NeMo Switchyard | 无官方调度组件 | 无官方调度组件 |
竞品差异总结
对比Qwen3.6 35B:二者激活参数一致、智能体准确率持平,但Nemotron 3.5 Lightning任务执行速度快30%,自带官方模型路由工具,对各类智能体框架做专项适配,本地低中端显卡部署兼容性更强;
对比Llama 3.1 34B稠密模型:稠密架构无稀疏激活优势,推理显存、算力成本大幅提升,无原生智能体加速技术,高频执行场景吞吐差距显著,商用授权存在额度约束。
七、常见问题解答(FAQ)
Q1:Nemotron 3.5 Lightning可以替代Nemotron 3 Ultra旗舰模型吗?
A:不可以,二者是分工协作关系。Nemotron 3 Ultra负责复杂规划、深度推理、全局决策;Nemotron 3.5 Lightning仅承接大批量、标准化、低复杂度的执行任务,搭配NeMo Switchyard分流才能发挥整套系统最优性能,无法单独处理复杂多步骤智能体规划。
Q2:普通消费级显卡最低什么配置能本地运行该模型?
A:搭载NVFP4量化权重后,RTX 5090(24GB显存)可流畅完整运行;Jetson高端嵌入式设备支持离线轻量化部署;16GB显存RTX显卡可加载量化精简版本,但并发量会受限。
Q3:模型开源协议OpenMDW-1.1是否支持企业商用?
A:支持,协议条款宽松,无商用额度、行业限制;官方完整开放权重、训练数据集、微调配方,企业可自由微调、二次分发、商业化落地。
Q4:推测解码DFlash和DSpark草稿模型该如何选择?
A:低并发、DGX Spark工作站本地推理场景选用DSpark;通用数据中心、中高并发负载选用DFlash;高并发大规模集群场景直接使用原生MTP多token预测方案。
Q5:该模型支持哪些主流智能体开发框架?
A:原生适配LangChain、OpenClaw、Hermes Agent、Kilo Code、OpenHands、Cline、Pi等;同时兼容vLLM、TensorRT-LLM、Ollama等推理引擎快速对接。
Q6:为什么在PinchBench基准上,同等准确率下比Qwen3.6 35B任务速度快30%?
A:核心两点优化,一是针对智能体工具调用流程做专属Harness训练,减少无效重试;二是NVFP4专用内核+双草稿推测解码协同优化,token生成、结果校验链路全流程压缩耗时。
Q7:NeMo Switchyard只能搭配Nemotron系列模型使用吗?
A:不是,该路由库兼容市面上主流开源、闭源大模型,可将Nemotron 3.5 Lightning作为执行层节点,搭配任意规划类模型构建混合调度系统。
八、相关链接
九、总结
NVIDIA Nemotron 3.5 Lightning是英伟达面向长时自治AI智能体推出的开源MoE轻量化专用模型,依托30B总参3B激活稀疏架构、原生推测解码与NVFP4量化加速技术,在同等智能体任务精度下实现远超同级模型的推理速度与算力效率,搭配原生NeMo Switchyard调度工具构建分层多模型智能体架构,有效解决单一旗舰大模型处理高频标准化执行任务时成本高、延迟大的行业痛点;模型采用宽松开源协议开放全部核心资源,覆盖从Jetson边缘设备、消费级RTX显卡到企业DGX集群的全硬件部署场景,兼容绝大多数主流智能体框架与推理工具,配套完整微调、运维、产业生态体系,为企业、开发者搭建低成本、高性能7×24小时持续运行AI智能体提供了标准化、可落地的完整技术方案。
版权及免责申明:本文由@AI工具集原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/nemotron-3-5-lightning.html