PixelUMM:NVIDIA联合滑铁卢大学开源的MoT混合专家多模态大模型
PixelUMM是什么
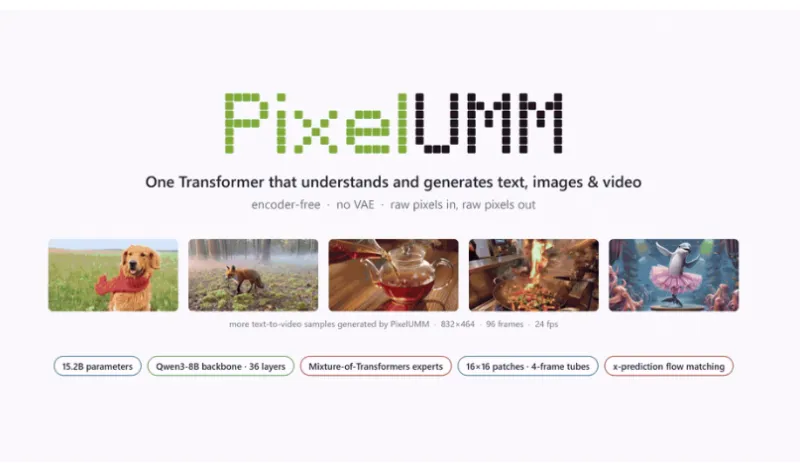
PixelUMM 全称 Encoder-Free Unified Image and Video Understanding and Generation,是 NVIDIA TLabs 联合滑铁卢大学推出的开源多模态大模型,主打无编码器统一图像、视频理解与生成。
传统多模态模型一般会分开设计两套模块:视觉编码器用来看懂图片视频,VAE潜变量模型负责图像视频生成。PixelUMM 打破这种设计思路,不再单独配置视觉编码器与VAE,直接基于原始像素做计算,使用一套Decoder-only Transformer架构,同时支持视觉理解、图像生成、视频续写生成、文本对话任务。项目代码采用Apache-2.0协议开源,模型权重托管在Hugging Face,权重仅支持非商用科研评估。
功能特色
无编码器极简视觉链路:移除独立ViT视觉编码器与VAE,直接对原始像素进行分块处理,减少模型中间转换带来的信息损耗,简化多模态处理流水线。
理解与生成一体化:单模型同时具备多模态理解和生成能力,既能做图文问答、视频内容解读,也支持文生图、视频续写,不需要切换多个模型。
MoT混合专家架构:主干注意力层共享,图像/视频理解、图像视频生成任务使用独立专家头,一套主干网络适配不同任务,平衡推理性能与效果。
图像、视频双模态原生支持:图像使用16×16像素Patch分块;视频采用时空Tubelet(16×16×4帧)对连续视频帧编码,原生适配时序视频数据。
基于Qwen3-8B语言基座:依托成熟的Qwen3-8B语言底座,保障文本对话、复杂指令理解能力,总模型参数量约15.2B。
技术细节
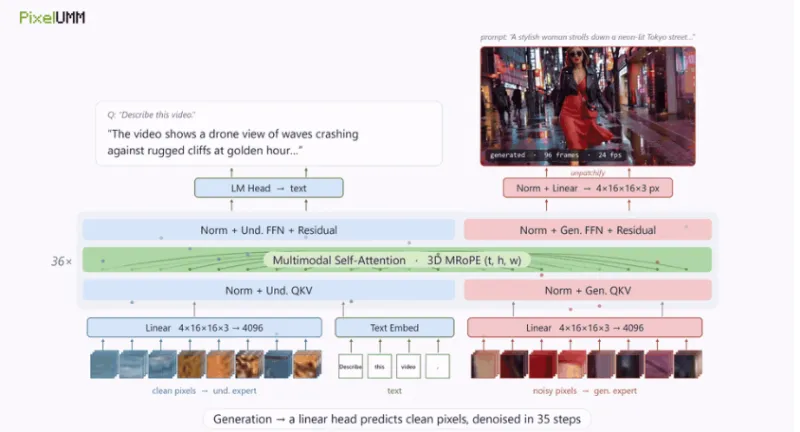
PixelUMM 采用Decoder-only Transformer作为基础骨架,核心亮点是像素级端到端处理,全程不使用潜变量空间。
图像输入处理:将原图切分为16×16像素大小的Patch,通过单层线性投影,把原始像素值映射到模型隐藏维度,送入Transformer。
视频输入处理:视频数据使用时空Tubelet,维度为16×16×4帧,同时捕捉空间画面信息和时间维度的帧变化,适配视频时序特征。
MoT(Mixture-of-Transformers)混合专家设计:Transformer的注意力模块在理解、生成任务之间共享;针对理解任务、图像生成、视频续写设置独立专家前馈头。不同任务调用对应的专家分支,共享主干注意力,大幅减少重复参数。
模型基座:语言部分基于Qwen3-8B,整体模型合计约15.2B参数。
输出方式:模型直接输出原始像素,不再借助VAE做解码,实现从像素输入到像素输出的端到端链路。
开源协议区分:项目代码Apache-2.0,模型权重采用NVIDIA自定义许可,仅限非商用科研评估,部分附属组件为CC-BY-NC协议。
应用场景
科研实验:多模态模型基础研究,用于探索无编码器像素级多模态统一建模方案,对比VAE、独立视觉编码器架构的优劣。
多模态内容原型开发:搭建一体化图文问答、视频问答Demo,同时实现文生图、短视频续写,一套模型完成理解+生成原型。
教学学习:学习统一多模态架构、MoT混合专家、视频时空编码等前沿技术,适合AI算法学习者研读源码。
媒体内容简易创作:小规模实验性图像生成、短片段视频续写,对图片、短视频做内容描述、问答分析。
注意:受权重许可限制,不可用于商业产品落地。
使用方法
克隆项目代码仓库
git clone https://github.com/nv-tlabs/PixelUMM.git
cd PixelUMM
安装项目所需依赖包,按仓库requirements配置环境,推荐使用支持CUDA的GPU环境。
从Hugging Face下载项目提供的分片模型权重,放置到指定权重目录。
运行仓库内置推理脚本,支持多种任务:图像问答、文生图、视频问答、视频续写生成。
配置参数,传入图片/视频或文本提示词,执行推理获取结果。
硬件提示:模型参数量大,推理需要高显存GPU资源。
竞品对比
选取Qwen2-VL、Gemini 1.5 Flash作为对比对象
| 项目名称 | 架构特点 | 核心能力 | 是否移除VAE/独立视觉编码器 | 权重商用限制 |
|---|---|---|---|---|
| PixelUMM | Decoder-only + MoT混合专家,像素端到端 | 图像/视频理解、文生图、视频续写、文本对话 | ✅ 无VAE、无独立视觉编码器 | 权重仅限非商用科研 |
| Qwen2-VL | ViT视觉编码器 + LLM语言主干,潜变量生成(文生图版本另独立模型) | 图像/视频理解,单独模型做图像生成 | ❌ 保留ViT视觉编码器,生成依赖独立模型 | 商用可申请授权 |
| Gemini 1.5 Flash | 原生多模态主干,独立视觉编码模块 | 图文视频理解,内置图像生成,视频生成能力有限 | ❌ 内置独立视觉处理模块 | 闭源API,不能本地部署权重 |
常见问题解答
问:PixelUMM可以直接商用开发产品吗?
答:不可以。项目代码是Apache-2.0协议,但模型权重为NVIDIA自定义许可,仅限非商用科研评估,附属部分组件为CC-BY-NC,商用会违反许可协议。
问:PixelUMM和普通VL多模态模型最大的差别是什么?
答:普通VL模型一般用独立视觉编码器提取图像特征,生成任务依靠VAE做潜变量编解码。PixelUMM直接处理原始像素,去掉VAE和独立视觉编码器,一套MoT架构同时完成视觉理解与图像视频生成。
问:运行PixelUMM需要什么硬件?
答:模型总参数量约15.2B,需要高显存NVIDIA GPU,显存大小取决于是否开启量化,原生全精度推理显存需求较高,不适合普通消费级显卡低显存环境。
问:PixelUMM支持多长的视频输入?
答:原生使用16×16×4帧的时空Tubelet处理视频,原生适配短片段视频,适合短视频理解与续写,不支持超长视频一次性输入。
问:PixelUMM是否支持量化推理?
答:仓库原生脚本未内置量化方案,可自行基于模型权重做量化适配,量化会一定程度影响图像生成与视觉理解效果。
相关链接
GitHub仓库:https://github.com/nv-tlabs/PixelUMM
arXiv论文地址:https://arxiv.org/abs/2609.38597
Hugging Face模型权重仓库:https://huggingface.co/nvidia/PixelUMM
总结
PixelUMM是NVIDIA TLabs与滑铁卢大学联合推出的无编码器统一多模态模型,通过移除VAE和独立视觉编码器,采用Decoder-only Transformer搭配MoT混合专家机制,实现原始像素端到端处理,单模型同时完成图像、视频的理解与生成任务,代码开源便于科研人员阅读和实验,但模型权重仅开放非商用科研评估,受显存门槛限制,更适合学术研究与原型验证,不适合直接投入商业化项目开发。
版权及免责申明:本文由@AI工具箱原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/pixelumm.html