
PixelUMM:NVIDIA联合滑铁卢大学开源的MoT混合专家多模态大模型
PixelUMM是NVIDIA TLabs联合滑铁卢大学开源的多模态大模型,移除VAE与独立视觉编码器,采用MoT混合专家架构,一套模型支持图像视频理解、文生图、视频续写,适合科研原型实...
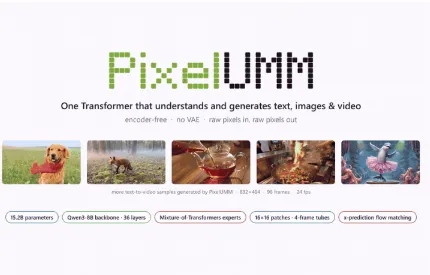
PixelUMM是NVIDIA TLabs联合滑铁卢大学开源的多模态大模型,移除VAE与独立视觉编码器,采用MoT混合专家架构,一套模型支持图像视频理解、文生图、视频续写,适合科研原型实...
LongCat-2.5-Preview是美团发布的预览版大模型,原生100万token上下文,新增图片多模态能力,强化代码Agent能力,兼容OpenAI、Anthropic双API协议,可用于源码库重构、超长...
ZDTaichu5.0‑9B,全称紫东太初5.0-9B,由武汉人工智能研究院发布,是一款9B参数、主打空间具身智能的开源通用多模态大模型。模型核心定位不再局限于图文问答,而是聚焦物理...
Ling-3.0-flash-VL是inclusionAI推出MIT协议开源原生多模态MoE大模型,支持图像、视频输入,百万级上下文,具备视觉Agent能力,支持SGLang、vLLM部署,可用于文档解析、视频...
Qwen3.8‑27B是阿里Qwen(通义千问)团队发布的270亿参数稠密(Dense)原生多模态开源大模型,归属于Qwen3.8模型系列,采用Apache 2.0开源协议,无营收门槛,个人、科研机构...
PerceptionBench 是 Moonshot AI(月之暗面)于2026年7月开源推出,专门面向多模态大模型(MLLM)原子级视觉感知能力的标准化评测基准,配套完整论文、数据集、可直接运行的...
Inkling 是由前 OpenAI CTO Mira Murati 创立的 Thinking Machines Lab(思维机器实验室)推出的从零完整训练、全权重开放商用通用多模态基础大模型,配套自研 Tinker 全链...
Qwen3.7-Plus是由阿里达摩院通义千问团队自研、依托Qwen3.7原生基座迭代升级的多模态通用智能体大模型,主打视觉+文本+代码三位一体的自主智能体闭环能力,Qwen3.7-Plus从底...
Step‑3.7‑Flash是阶跃星辰开源的生产级Agent专用多模态大模型,采用稀疏MoE架构,总参数198B、激活参数11B,最高生成速度400 Tokens/s,支持256K上下文与三级推理级别。模...
Mamoda2.5 是字节跳动 Mamoda 团队自研推出的开源统一多模态大模型,依托 DiT-MoE 稀疏混合专家架构 打造,采用 AR-Diffusion 统一建模范式,实现多模态理解、内容生成、智...
Muse Spark是Meta超级智能实验室打造的首款原生多模态推理AI模型,主打文本、图像深度融合理解,提供即时、思考、沉思三级推理模式,支持16并行智能体协同与视觉思维链,在...
Kimi K2.5是由北京月之暗面科技(Moonshot AI)发布的开源多模态大模型,同步上线于Hugging Face官方仓库,是Kimi系列模型的重磅升级版本。其核心定位是“面向全场景的高性...
STEP3-VL-10B是阶跃星辰(StepFun AI)开源的轻量级多模态基础大模型,核心定位是在10B(100亿)参数的紧凑规模下,实现高效性与前沿多模态智能的极致平衡,打破“参数越大...
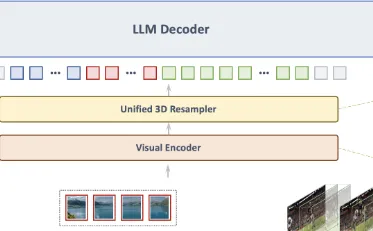
深度解析 MiniCPM-V 4.5 多模态大模型,手把手教你完成本地部署。支持高精度 OCR 与长视频理解,基于 Ubuntu 环境,适配 GGUF 量化,轻松在消费级硬件运行视觉语言模型。
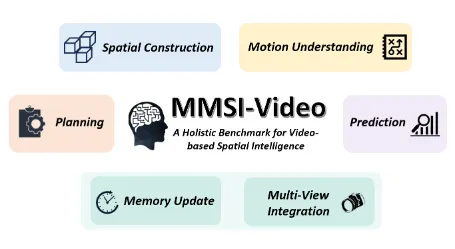
MMSI-Video-Bench是一款开源的视频空间智能专项评测基准。该基准聚焦多模态大模型(MLLMs)在视频场景下的空间智能能力评估,构建了覆盖“感知-规划-预测-跨视频推理”的四...