Strata:消费级PC运行超大MoE模型的C++推理引擎
一、Strata是什么
Strata 是由 Niko1221 开发、基于 MIT 开源协议的 C++ 实现 MoE 大模型推理引擎。项目核心目标是让普通家用消费级电脑,在 12~24GB 显存的 NVIDIA 显卡上本地运行 125B 参数 Qwen3.8-Flash-Next 混合专家大模型。
该引擎采用分层权重存储策略,把高频使用的网络层放置在GPU显存,庞大的专家权重转移至系统内存RAM,依靠CPU与GPU协同完成推理计算,突破GPU显存容量瓶颈。它并非通用大模型推理框架,当前版本专门适配 Qwen3.8-Flash-Next 这一款MoE模型,支持Windows与Linux双平台,自带OpenAI兼容API,可对接各类AI客户端。
二、功能特色
显存突破方案:分层权重调度,将活跃层放显存、专家权重放在内存,12G显存显卡也可加载125B大MoE模型。
跨平台支持:原生支持 Windows、Linux 系统,提供一键启动脚本,Windows平台
START-HERE.bat,Linux提供对应shell脚本。兼容OpenAI接口:内置和OpenAI、Anthropic兼容的本地API服务,第三方AI聊天客户端可直接接入使用,支持图片输入能力。
超大上下文窗口:最高支持262K上下文长度,适合长文档阅读、长文本分析场景。
硬件自动校准:内置
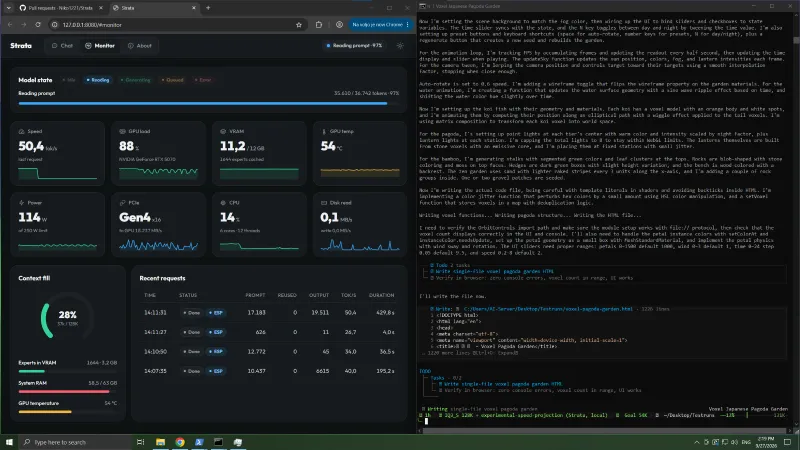
--calibrate校准工具,自动检测本机硬件,调优推理调度参数,适配不同PC配置。高性能推理表现:在RTX5070-12G搭配R5-7600、64GB DDR5,2bit量化条件下,生成速度可达45~95 token/s,Prompt读取速度285~571 token/s。
三、技术细节
Strata 核心创新是分层权重存储与CPU-GPU协同推理。
MoE模型特点是总参数量巨大,但每次推理只会激活少量专家。Strata利用这个特性,对模型权重做分层:Transformer基础层、高频访问层常驻GPU显存;数量庞大、单次推理只少量调用的专家权重存放在系统内存RAM。推理过程按需从内存读取专家参数,完成计算。
编程语言:纯C++开发,轻量化,减少Python运行时开销。
模型适配范围:仅针对 Qwen3.8-Flash-Next 125B MoE模型,不支持其他LLM。
量化支持:支持2bit量化,大幅降低权重占用空间,降低内存与SSD压力。
硬件依赖:仅支持NVIDIA显卡,依赖CUDA;AMD显卡、Intel核显/独显暂不兼容。
存储要求:模型权重文件体积较大,推荐高速NVMe SSD,磁盘读写速度会直接影响专家权重加载延迟。
配套文档:仓库自带技术论文
docs/paper/Strata-Paper.pdf,完整阐述底层调度算法、实验基准测试数据。
四、应用场景
本地私有大模型部署:个人电脑本地运行百亿级MoE模型,所有数据不上传公网,保障文档、资料处理隐私。
长文本本地处理:依托262K超长上下文,本地完成长篇小说、合同、技术文档批量阅读、摘要、内容改写。
离线AI助手服务:本地启动OpenAI兼容API,对接各类开源AI客户端,搭建离线私人对话服务。
大模型技术学习研究:适合AI开发者学习MoE混合专家模型的推理调度、显存内存分层加载原理。
不适用场景:生产高并发服务部署;AMD显卡设备;内存小于32GB的低配电脑;需要同时运行多款不同大模型的场景。
五、使用方法
获取源码:克隆GitHub仓库代码,下载到本地。
环境准备:搭载NVIDIA显卡,推荐显存12GB以上,内存最低32GB,推荐64GB,NVMe高速SSD。
一键部署:Windows系统运行
START-HERE.bat脚本,脚本自动完成环境依赖安装、模型权重下载;Linux系统执行对应sh脚本。硬件校准(可选):启动脚本增加
--calibrate参数,自动检测硬件,优化推理调度参数。启动推理服务:脚本完成配置后,启动本地推理服务。
接入使用:通过内置OpenAI兼容API地址调用,也可直接在命令行和模型对话。
六、竞品对比
选取 llama.cpp、vLLM 两个主流推理框架进行对比。
| 项目 | Strata | llama.cpp | vLLM |
|---|---|---|---|
| 核心定位 | 家用PC跑超大MoE专用推理引擎 | 轻量通用大模型推理框架 | 高性能GPU推理服务引擎 |
| 模型支持范围 | 仅适配Qwen3.8-Flash-Next 125B MoE | 支持绝大多数LLM、MoE模型 | 支持主流开源LLM与部分MoE模型 |
| 核心技术 | 显存+内存分层权重调度,CPU-GPU协同 | GGUF量化,内存映射,CPU/GPU混合推理 | PagedAttention分页注意力,GPU显存优先调度 |
| 目标硬件 | 12G+显存消费级NVIDIA显卡,64GB内存 | CPU、NVIDIA、AMD多硬件兼容 | 高端NVIDIA显卡,优先GPU显存充足设备 |
| 长上下文 | 最高262K | 依赖模型本身上限 | 支持超长上下文 |
| 使用门槛 | 一键脚本,仅单模型可用 | 模型选择丰富,配置参数较多 | 生产向,部署配置复杂,低配PC性能差 |
七、常见问题解答
问:Strata支持AMD显卡吗?
答:不支持。Strata底层依赖CUDA,仅支持NVIDIA显卡,AMD、Intel独显/核显无法运行。
问:Strata能不能跑Llama、Qwen其他系列模型?
答:不能。当前Strata为定制开发,只适配Qwen3.8-Flash-Next 125B MoE模型,不支持其他大模型。
问:电脑内存32GB可以运行吗?
答:Coder版本最低32GB内存,推荐使用64GB内存;内存不足会频繁读写磁盘,推理速度大幅下降,甚至无法启动。
问:SSD速度对Strata推理速度影响大吗?
答:影响很大。专家权重需要从磁盘加载,低速SATA硬盘会造成严重卡顿,强烈建议使用NVMe高速固态硬盘。
问:Strata推理出来的速度是固定值吗?
答:不是,速度取决于显卡性能、内存带宽、模型量化等级、输入prompt长度。文档给出的45~95 token/s是特定硬件下的测试参考值。
问:Strata可以用于线上生产环境对外提供服务吗?
答:不推荐。项目面向本地单机个人研究使用,没有做高并发、稳定性优化,不适合生产环境部署。
八、相关链接
GitHub仓库:https://github.com/Niko1221/Strata
九、总结
Strata 是一款面向家用消费级PC、基于C++开发的专用MoE大模型推理引擎,依靠显存与内存分层存储技术,解决普通显卡显存不足的痛点,让12GB显存NVIDIA设备能够本地部署125B参数的Qwen3.8-Flash-Next模型,自带一键部署脚本与OpenAI兼容接口,适合个人离线本地AI使用和MoE推理技术学习,缺点是模型支持单一,硬件限制较多,仅适合NVIDIA显卡的个人单机场景。
版权及免责申明:本文由@AI铺子原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/strata.html