
Tomur:基于.NET的开源本地AI运行时与开发者工作台
Tomur是IoTSharp推出基于.NET10 C#开源本地AI运行时,双推理后端,支持离线本地大模型、Web对话、HTTP接口,适配.NET开发与物联网边缘AI场景。
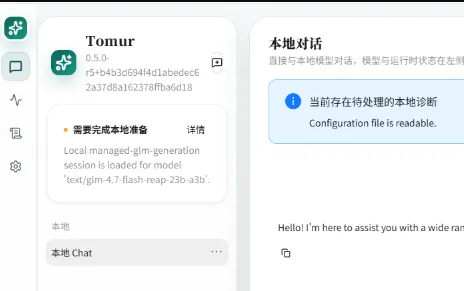
Tomur是IoTSharp推出基于.NET10 C#开源本地AI运行时,双推理后端,支持离线本地大模型、Web对话、HTTP接口,适配.NET开发与物联网边缘AI场景。
Strata是C++开发的MoE大模型推理引擎,分层存储突破显存限制,12G显存NVIDIA显卡本地运行125B Qwen3.8-Flash-Next,支持OpenAI兼容API,超长上下文,Windows/Linux一键部署...
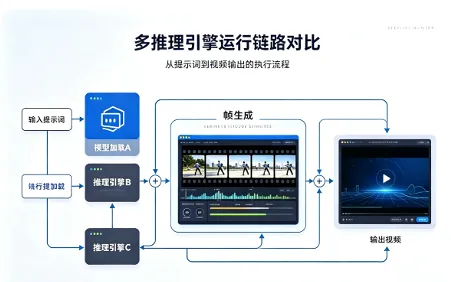
横向对比Byte轻量引擎、ComfyUI Video、Diffusers、vLLM视频分支,讲解各自优缺点与本地AI视频推理选型方法。
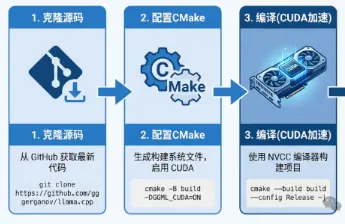
本文完整讲解使用 llama.cpp 本地离线部署 Qwen3.6‑27B 大模型,包含 GGUF 模型下载、编译、量化选择、命令行交互、OpenAI 兼容 API 搭建、硬件适配以及常见踩坑解决。
FreeToken 是由 FlashML‑org 开源、基于 Apache‑2.0 开源协议发布的边缘原生MoE(混合专家)大模型推理服务引擎,该项目核心目标,让消费级普通PC、笔记本、工作站这类边...
Muse‑Glimmer‑30B是Meta AI开源发布的30B参数稠密多模态大模型,由Meta旗舰闭源模型Muse‑Spark蒸馏而来,采用Apache 2.0开源协议,支持个人与企业免费商用。
llmfit 是由 AlexsJones 开发的开源跨平台终端工具,基于Rust开发,用于检测本地硬件资源,自动筛选适配本机硬件条件的大语言模型,解决本地部署大模型时盲目下载模型引发内...
whichllm是开源Python命令行工具,结合硬件算力、显存测算与公开评测数据,自动筛选适配本地硬件的开源大模型,支持显卡模拟、硬件规划、输出推理代码。
local‑llm 是开源的本地大模型完整落地工程,不是单一推理框架,是一套从硬件选型、底层BIOS/内核调优、多GPU通信优化、容器化模型推理到本地语音识别、AI智能体应用的全栈...
Rapid-MLX 是一款基于苹果官方 MLX 机器学习框架二次封装优化的开源高性能本地大语言模型(LLM)推理服务引擎,专为Apple Silicon 全系列芯片(M1~M4)Mac 设备深度定制开发...
详细图文教程|在RTX 3060显卡上部署MiniCPM4边缘大模型:含Conda环境创建、modelscope模型下载、accelerate修复、Gradio演示配置及CPM.cu推理优化实操。支持128K长文本与3...
详解 llama.cpp 架构原理、GGUF 模型格式、Q4_K_M 量化策略、CPU/GPU 部署实战、API 服务配置及 2025 新增路由模式。涵盖树莓派/Mac/Windows/Linux 全平台,附故障排查与性...
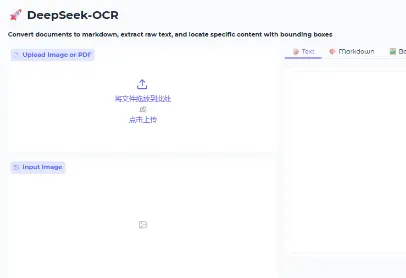
DeepSeek-OCR本地部署指南:仅需16G显存,手把手教你搭建支持高分辨率文档识别的OCR系统,含Conda环境、模型下载、Gradio可视化全流程。

Gerbil 是一款专为本地运行大型语言模型(LLM)而设计的桌面应用程序,基于高度优化的 KoboldCpp 引擎构建。它允许用户在无需依赖云端服务的情况下,在自己的设备上轻松加载...