VDN-MiniMax-H3:基于MiniMax H3的视频生成加速开源项目
一、VDN-MiniMax-H3是什么
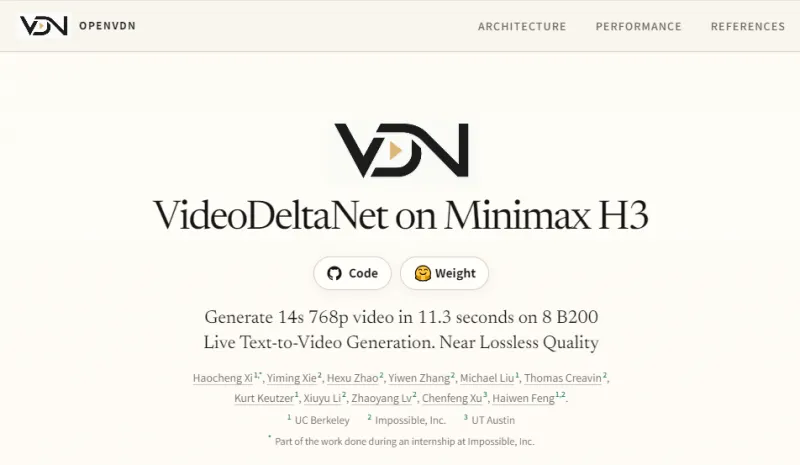
VDN-MiniMax-H3全称Video DeltaNet,是一个基于MiniMax H3视频大模型开发的视频生成加速开源项目。项目不改动MiniMax H3原始主干权重,通过新增混合注意力分支与LoRA适配器,在基本不损失视频画质的前提下,大幅降低推理耗时,同时完整开放训练代码、推理脚本与两套权重(50步标准版、8步Turbo极速版)。
项目核心思路:冻结原始H3主干网络,额外引入线性注意力分支对齐原模型输出,搭配蒸馏得到的Turbo权重,实现高速视频生成,支持单卡、多卡分布式FP8推理。
二、功能特色
无损级画质加速:新增线性注意力分支,保留原有softmax时序注意力保障视频连贯性,加速后画面抖动、失真问题控制在极低水平。
双版本权重选择:提供50步基础权重保证最高画质;8步Turbo蒸馏权重,实现极速生成,适合快速预览。
多GPU分布式推理:原生支持单卡与多卡集群部署,适配B200、H200显卡,支持FP8量化推理,降低显存占用。
完整开源链路:Apache 2.0开源推理、训练全套代码,从预编码数据读取、模型训练到视频推理生成全流程开放。
轻量化改造:不修改原始MiniMax H3主干权重,仅新增线性注意力分支与小型LoRA适配器,兼容原有H3模型生态。
配套提示词编码方案:借助Qwen3-VL-32B完成文本提示词编码,将提示词转为pt潜变量文件送入模型推理。
三、技术细节
混合注意力架构
Softmax注意力分支:沿用MiniMax H3原生时序注意力,负责维持视频帧间时序一致性,保障画面流畅。
线性注意力分支:新增分支,降低注意力计算复杂度,减少推理算力开销,通过训练对齐原模型输出分布。
四阶段训练流程:主干模型全程冻结,仅训练新增模块与LoRA
A1阶段(200步):训练线性注意力分支,逐层对齐原始模型输出
A2阶段(500步):端到端整体训练线性注意力分支
B阶段(2000步):训练QKV/O投影层LoRA,联合优化线性分支
DMD蒸馏阶段(250步):DMD2无GAN蒸馏训练8步Turbo LoRA,仅依赖文本数据
推理技术:FP8量化推理,支持Triton算子加速;首次运行自动编译算子,后续复用编译缓存;输入为预编码的视频、音频、文本潜变量,通过
video_index.jsonl读取数据集元信息。硬件性能参考(不计模型加载、VAE解码、视频编码耗时)
| 硬件环境 | 推理配置 | 生成耗时 |
|---|---|---|
| B200 单卡 | FP8,8步Turbo | 51秒 |
| B200 8卡分布式 | FP8,8步Turbo | 11.23秒 |
| H200 单卡 | FP8,8步Turbo | 90.5秒 |
| H200 8卡分布式 | FP8,8步Turbo | 18.3秒 |
8卡B200环境下,生成14.4秒768p视频仅需11.23秒,生成速度超过视频播放速度。
四、应用场景
AI视频内容工作室:批量生成短视频素材,快速迭代提示词预览效果。
模型研究与二次开发:研究视频生成注意力优化、模型蒸馏技术,基于该项目做进一步算法改进。
影视前期概念预览:快速生成故事板动态视频,给导演、美术做创意参考。
开源模型部署学习:学习多卡分布式、FP8量化、潜变量训练、视频大模型推理工程落地。
企业内部原型验证:搭建私有化视频生成服务,不对外商用时基于开源代码做内部测试。
注意:模型权重归属MiniMax H3社区协议,使用权重需要遵守对应的许可协议。
五、使用方法
1. 环境准备
Python3.12、PyTorch2.13(cu129)、FlashAttention4,需要打补丁版本diffusers。推荐使用conda隔离环境。
# 克隆仓库
git clone [https://github.com/OpenVDN/vdn-minimax-h3](https://github.com/OpenVDN/vdn-minimax-h3)
cd vdn-minimax-h3
# 创建并安装依赖,执行脚本修补diffusers
2. 权重下载
权重总大小约82GB,放置在项目ckpts目录:
H3基础权重:72GB
50步标准版权重:4.3GB
8步Turbo权重:5.1GB
权重托管于HuggingFace。
3. 提示词预处理
使用Qwen3-VL-32B将文本提示词编码,输出.pt潜变量文件,作为推理输入;官方建议对提示词做优化改写,提升生成效果。
4. 执行推理
仓库内置shell脚本,区分单卡、8卡B200、8卡H200三种环境,直接调用脚本加载pt文件生成视频。
5. 模型训练
准备预编码视频、音频、文本潜变量数据集,配置video_index.jsonl,按A1→A2→B→DMD四个阶段顺序启动训练,支持断点续训。
六、竞品对比
选取2个同类型开源视频生成加速项目进行对比:
| 项目 | 底层基座 | 加速方案 | 开源程度 | 硬件要求 |
|---|---|---|---|---|
| VDN-MiniMax-H3 | MiniMax H3 | 新增线性注意力分支+LoRA蒸馏 | 代码Apache2.0,权重遵循MiniMax协议 | 推荐B200/H200多卡,支持FP8 |
| Open-Sora Plan | Open-Sora | 采样步数蒸馏、模型量化 | 全部代码+权重开源 | A100/H100,显存需求高 |
| CogVideoX-Fun | CogVideoX | 模型分片、采样器优化 | 代码开源,权重开源 | 单卡4090可跑,高分辨率生成慢 |
七、常见问题解答
问:VDN-MiniMax-H3可以单独脱离MiniMax H3主干使用吗?
答:不可以。VDN-MiniMax-H3只是在原始MiniMax H3之上增加的注意力分支与LoRA适配器,主干必须加载原版MiniMax H3权重,无法独立运行。
问:项目代码和模型权重是同一个开源协议吗?
答:不是。仓库内代码使用Apache-2.0协议;HuggingFace上托管的模型权重遵循MiniMax H3社区许可协议,二者协议相互独立,使用权重需要遵守MiniMax的相关约束。
问:普通消费级显卡(RTX4090)可以跑这个项目吗?
答:硬件门槛很高。模型整体权重巨大,FP8推理、FlashAttention4以及多卡分布式设计主要面向B200、H200等数据中心GPU。RTX4090显存不足,无法完成完整推理,不推荐尝试。
问:推理时为什么要先用Qwen3-VL-32B编码提示词?不能直接输入文本吗?
答:该项目推理链路设计为读取预编码潜变量文件,原生不支持直接输入文本,所以需要借助Qwen3-VL-32B将文本转为pt潜变量文件,作为模型输入。
问:Turbo版本相比50步版本画质差距大吗?
答:8步Turbo版本通过DMD2无GAN蒸馏得到,在大部分场景下肉眼画质损失较小;复杂动态、长镜头场景,50步标准版画面细节与时序稳定性更好。
八、相关链接
项目官网:https://openvdn.github.io/
GitHub仓库:https://github.com/OpenVDN/vdn-minimax-h3
HuggingFace模型库:https://huggingface.co/OpenVDN/vdn-minimax-h3
九、总结
VDN-MiniMax-H3面向MiniMax H3视频大模型,采用新增线性注意力分支搭配LoRA蒸馏的方案,在保留原有视频生成能力的前提下实现推理加速,完整开放训练与推理代码,提供标准版与Turbo两套权重,支持FP8量化与多卡分布式部署。该项目适合AI视频算法研究者、模型工程开发人员学习视频模型注意力优化与推理加速技术,但硬件门槛较高,权重使用需要遵守MiniMax H3社区许可协议。
版权及免责申明:本文由@AI工具集原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/vdn-minimax-h3.html