VoiceStudio:开源离线语音工具箱,支持多引擎TTS、批量有声书生成
VoiceStudio 是什么
VoiceStudio(曾用名 OmniVoice‑Studio)是一款开源本地语音工作台项目,项目仓库托管在 GitHub,采用 AGPL‑3.0 开源协议。项目定位对标 ElevenLabs,所有语音相关推理运算全部在本地设备完成,不需要调用云端 API、无需注册账号,不存在订阅付费成本。
支持 Windows、macOS、Linux 全平台运行,兼容 CPU、NVIDIA CUDA、AMD ROCm、Apple Silicon 硬件加速,同时支持 Docker 容器化部署,分为桌面客户端版本与 Web API 服务版本。用户可以在本地完成语音克隆、文本转语音、语音转文字、视频配音等一系列音频处理工作。
功能特色
零样本语音克隆:上传简短音频样本就能复刻音色,可手动调整音色参数,包含年龄、性别、口音、音高、情绪等维度,自定义生成个性化人声。
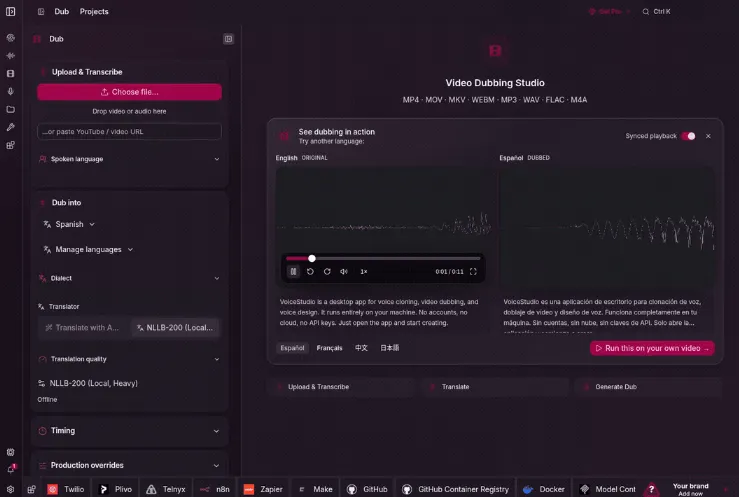
离线视频配音流水线:一站式完成视频语音转录、文本翻译、AI重新配音、视频合成导出,整套流程离线执行,不用上传视频到第三方服务器。
本地ASR语音转写与全局听写:内置全局快捷键,支持在任意软件内实时语音转文字,满足实时记录、字幕提取需求。
长文本批量有声书生成:针对长篇文稿批量合成音频,适合制作有声读物、长文稿朗读音频。
多引擎多语言支持:内置16套TTS引擎、11套ASR引擎,覆盖646种语言,语种覆盖范围广。
OpenAI兼容音频API与MCP服务:提供兼容OpenAI格式的音频接口,可对接Cursor、Claude等AI工具链,方便集成到自有工作流。
技术细节
开发主体:Python 后端,桌面端使用 Bun 构建前端界面,提供桌面GUI、WebUI两套交互入口。
硬件适配:原生支持CPU推理;NVIDIA显卡使用CUDA加速,AMD显卡支持ROCm,苹果硅芯片可调用Metal加速。
部署形态:桌面安装包、源码启动、Docker容器三种部署方案。Docker镜像同时提供Web操作界面与API接口,方便服务化调用。
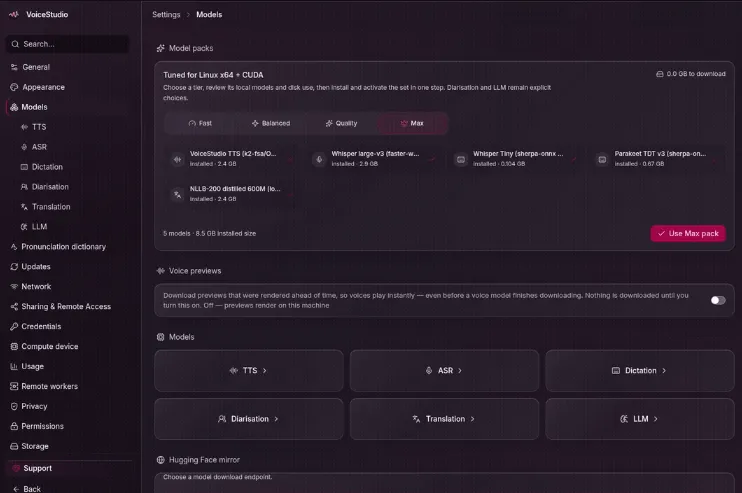
模型机制:项目内置多款TTS、ASR开源模型,首次启动会自动下载模型权重。模型总占用空间较大,建议预留10GB以上磁盘空间。
接口规范:音频API遵循OpenAI兼容格式,附带MCP协议服务,便于和其他AI应用打通。
开源协议:AGPL‑3.0,修改并对外提供服务时,需要开源修改后的代码;项目内部分模型权重有独立许可,部分模型禁止商用。
应用场景
自媒体视频制作:本地给短视频替换配音,提取原有字幕,翻译后生成新配音,保护素材隐私。
有声内容创作:批量把小说、文稿转成有声书音频,本地生成不泄露原文。
办公实时听写:全局语音转文字,会议记录、访谈笔录、写作口述输入。
本地AI工作流集成:通过API接入本地AI智能体,为AI应用增加本地语音输入输出能力。
语言学习:多语种语音朗读,辅助听力练习。
配音小样制作:快速生成不同音色配音样稿,适合配音策划前期测试。
使用方法
方案一:桌面安装包(推荐普通用户)
打开项目GitHub仓库,进入Releases发布页。
根据你的操作系统,下载对应版本安装包。
安装完成后启动VoiceStudio,程序会自动下载所需模型文件,等待模型下载完毕。
在图形界面选择功能模块:TTS语音合成、语音克隆、ASR转写、视频配音等。
上传音频样本(克隆音色时)或者粘贴文本,调整音色、语速、情绪参数,执行生成,导出音频或视频。
方案二:源码运行
git clone https://github.com/debpalash/VoiceStudio.git
cd VoiceStudio
bun install
bun run desktop
执行命令前需要提前配置好Python环境与Bun运行时。
方案三:Docker部署
拉取官方镜像 ghcr.io/debpalash/voicestudio,启动容器后,同时访问WebUI页面或者调用配套音频API。
竞品对比
| 项目 | 部署方式 | 是否本地推理 | 核心差异 |
|---|---|---|---|
| VoiceStudio | 桌面客户端 / Docker / 源码 | ✅ 全部本地离线 | 多引擎TTS+ASR一体,自带视频配音流水线,OpenAI兼容API,AGPL开源,免费本地运行 |
| ElevenLabs | 云端网页/API | ❌ 云端推理 | 音色质量优秀,但是需要付费订阅,素材上传云端,不支持本地离线,无内置ASR |
| Coqui TTS | 源码部署 | ✅ 本地推理 | 专注TTS语音合成,无内置ASR、视频配音功能,缺少桌面GUI,上手难度更高 |
常见问题解答
Q:VoiceStudio 生成的语音可以商用吗?
A:项目代码协议为AGPL‑3.0,但项目内置的各个模型权重拥有独立许可协议。部分模型不允许商用,使用前务必单独查看每个模型的许可声明,商用需要满足对应模型授权要求。
Q:语音克隆功能有没有法律风险?
A:仅允许克隆本人声音,或者已经获得对方书面授权的音色。未经授权克隆他人声音用于任何用途,都存在法律风险,严禁滥用。
Q:最低硬件配置要求是什么?
A:磁盘预留至少10GB空间用于存放模型;内存建议8GB及以上。CPU可以运行,但是生成音频速度很慢;NVIDIA、AMD、Apple Silicon显卡开启硬件加速后,生成速度会大幅提升。
Q:中文合成效果怎么样?
A:项目原生支持中文,但中文音色效果需要手动调试参数,不属于开箱就达到最优效果,建议多尝试不同TTS引擎对比试听。
Q:Docker部署之后,怎么调用API?
A:Docker启动成功后,服务自带OpenAI兼容音频接口,可以直接使用OpenAI格式请求地址,搭配MCP服务接入各类AI客户端。
Q:模型下载失败怎么处理?
A:网络问题是模型下载失败最常见原因,可以手动下载模型权重放到指定本地目录,修改配置文件指向本地模型路径。
相关链接
GitHub项目主页:https://github.com/debpalash/VoiceStudio
总结
VoiceStudio是一套一体化开源本地语音工作台,整合了TTS、ASR、语音克隆、视频配音等多项音频能力,依托本地硬件完成全部推理计算,无需云端API,提供桌面端、源码、Docker三种部署方式,兼顾普通用户图形化操作与开发者API集成需求,多引擎多语种的设计可以适配自媒体创作、有声书制作、办公听写等多种场景,使用时需要留意开源协议、模型版权以及语音克隆相关法律规范。
版权及免责申明:本文由@97ai原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/voicestudio.html