
Yovoice:开源本地AI语音工作台,支持音色克隆与AI歌曲生成
Yovoice是开源本地离线语音工作台,支持TTS文字转语音、音色克隆、多角色有声书配音、AI歌曲生成、MIDI编曲,Windows/macOS可用,不上传素材,无云端扣费。
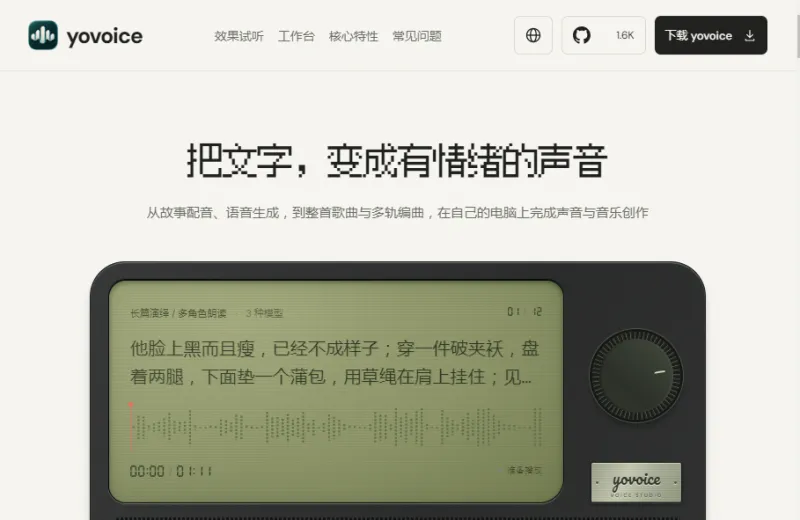
Yovoice是开源本地离线语音工作台,支持TTS文字转语音、音色克隆、多角色有声书配音、AI歌曲生成、MIDI编曲,Windows/macOS可用,不上传素材,无云端扣费。
HeyGen Voice是HeyGen自研AI语音大模型,支持文本转语音、即时/专业语音克隆,原生配套数字人Avatar,实现语音与口型精准同步,可独立导出音频或生成数字人视频,附带API接...
VoiceStudio是开源本地语音工作台,全部推理本地执行,支持零样本语音克隆、ASR语音转写、视频离线配音、批量有声书生成,提供桌面端、Docker部署,内置多语种TTS/ASR引擎。...
Qwen-Audio-3.1是阿里云通义千问新一代全套音频大模型,包含Realtime实时语音Agent、ASR语音识别、TTS声景生成,支持全双工对话、方言识别、分角色转写,提供API接入方案。
AuK 是腾讯混元团队开源的1.5B参数语音基础模型,采用MIT开源协议。它最大的特点是使用自然语言统一指令接口,把语音合成、语音编辑、语音增强、声源分离等多种语音任务整合...
FireRedAudio是小红书开源发布的通用音频语言大模型,基于9B参数主干模型,采用解耦连续表征架构,单模型同时实现音频理解、语音生成、语音编辑三大类能力。
Breeze TTS 2是国内AI语音企业BreezeBlue发布的新一代TTS语音合成模型。它专门面向实时人机交互场景,将语音设计、角色演绎、低延迟流式生成整合为一体化模型,不再局限传统...
FireRedTTS3是小红书推出的开源PyTorch端到端语音生成项目,基于语义增强连续语音表征技术,分为Base、Instruct两大模型版本,采用Apache‑2.0开源协议。项目兼顾零样本音色...
Luna‑TTS是VUI Labs(宇生月伴)研发的扩散‑语言模型架构的文本转语音(TTS)项目,整套家族包含Luna‑TTS全并行版本、Luna‑TTS Realtime实时流式两个子模型,主干网络参...
dots.tts 是 小红书dots团队联合上海交大X‑LANCE实验室开源的全连续端到端自回归TTS语音合成基座项目,Apache‑2.0开源协议,总参数量约20B,最大特点是全程不使用离散声学...

Vocalove是网页端AI声音克隆工具,仅需3~30秒音频样本即可复刻人声,免安装浏览器直接使用,支持内置TTS音色,可生成纯音频或者会说话人像纪念视频,免费预览,一次性点数...
MAI-Voice-2-Flash是微软于2026年7月官方发布、基于自研MAI语音基座训练的极速低延迟文本转语音(TTS)模型,隶属于微软MAI语音模型家族,依托Azure AI Foundry与Azure语音...
Qwen-Audio-3.0-TTS 是阿里巴巴 Token Foundry 团队研发的工业化高质量语音合成模型,归属通义千问音频系列。模型面向真实生产场景打造,主打高保真音色克隆、多语种与汉语...
ViiTorVoice-NAR是viitor-ai开源非自回归语音生成工具,支持零样本音色克隆、文本局部音频修改、60ms超低延迟推理,提供Gradio可视化、gRPC微服务、Docker容器部署,原生中...
Confucius4-TTS是网易有道推出基于LLM架构的开源跨语种零样本语音合成引擎,支持14种语言免参考文本音色克隆、无口音跨语种语音迁移、音频情感同步复刻,提供在线Gradio演示...