WeMM‑Embedding:腾讯微信开源的多模态向量嵌入模型
一、WeMM‑Embedding是什么
WeMM‑Embedding是腾讯微信视觉团队开源的通用多模态向量嵌入模型家族,基于Apache‑2.0开源协议发布,模型权重托管于Hugging Face平台。
该模型能够把文本、图片、视频、视觉文档、图文交错混合输入,映射到同一个向量空间,输出归一化的特征向量,用于多模态检索业务。模型家族包含2B、4B、9B三种参数规模,覆盖轻量部署到高精度业务的不同需求,项目同时开放推理、服务部署、完整评测全套代码,方便开发者直接复现结果与二次开发。
模型不支持音频输入,音频相关任务无法使用该模型处理。
二、功能特色
多模态统一向量空间:文本、图像、短视频、扫描文档、图文交错内容共用一套模型编码,不同模态向量可以直接做相似度比对,实现跨模态检索。
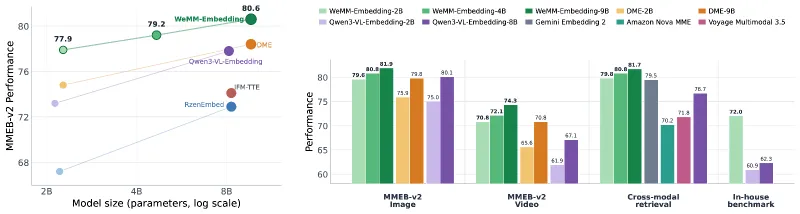
Matryoshka嵌套向量MRL:支持嵌套向量输出,原生支持64‑4096多维度输出,向量可以直接截断后重新归一化,在少量损失精度前提下降低向量存储开销,适配向量数据库。其中2B版本截断至256维,图像视频任务仍可保留98.7%完整维度性能。
多规模模型选型:2B轻量模型适合边缘、低显存环境;4B兼顾性能与硬件成本;9B面向追求最高检索精度的服务端场景。
高性能视频编码:内置视频帧采样逻辑,支持长视频片段输入,可直接对视频生成向量,无需拆图手动处理。
完整工程化能力:原生兼容transformers、sentence‑transformers调用方式;支持vLLM、SGLang高性能推理服务部署;附带MMEB‑v2、MMEB‑v3两套大规模评测基准,可快速完成模型效果自测。
三、技术细节
输入输出机制
模型读取输入之后,取专用<embedding>特殊token的最后一层隐状态,经过L2归一化,得到最终可用嵌入向量。支持文本、单图、多图、视频、图文交错序列输入;音频输入不在模型能力范围内。模型参数与向量维度范围
| 模型版本 | 支持向量输出维度范围 |
|---|---|
| WeMM‑Embedding‑2B | 64‑2048 |
| WeMM‑Embedding‑4B | 64‑2560 |
| WeMM‑Embedding‑9B | 64‑4096 |
评测体系
项目提供两套评测数据集MMEB‑v2、MMEB‑v3。MMEB‑v2包含78个数据集,侧重图像视频检索,评估Hit@1、NDCG@5指标;MMEB‑v3扩展至190项任务,增加文本、智能体相关检索任务。评测代码基于VLM2Vec流水线改造,支持多机多卡评测、64帧视频采样适配,所有评测脚本开源可复现。部署依赖
推荐transformers版本为5.2.0;高性能服务部署支持vLLM 0.27.0、SGLang 0.5.9;项目根目录提供requirements.txt一键安装依赖。开源协议
主体代码Apache‑2.0,部分第三方组件沿用原有许可证,商用场景需要核对第三方组件版权声明。
四、应用场景
跨模态检索系统:以文搜图、以图搜文、以文搜视频、视频检索,图库、短视频内容库检索。
文档知识库检索:扫描件、截图、图文混排文档做向量化入库,实现图文混合知识库检索。
内容去重与内容聚类:图片、短视频素材库做重复内容识别,素材聚类分类。
RAG多模态知识库:面向图文混合知识库,把图片、截图、文档页面转为向量接入向量数据库,实现多模态RAG。
内容安全、素材过滤业务:计算素材相似度,做相似素材召回、内容过滤。
五、使用方法
1. 环境准备
克隆项目仓库,安装依赖:
git clone https://github.com/Tencent/WeMM-Embedding
cd WeMM‑Embedding
pip install -r requirements.txt
建议transformers固定使用
5.2.0版本,避免版本不兼容。
2. Transformers原生调用
项目examples目录提供示例代码,可分别对文本、图片、视频进行编码获取向量。读取模型权重,传入对应模态输入,获取<embedding>token输出,执行L2归一化得到向量。
3. Sentence‑Transformers调用
Hugging Face权重可直接被sentence‑transformers加载,调用.encode()接口,传入文本、图像、视频数据直接输出向量,上手成本更低。
4. 高性能服务部署
使用vLLM或者SGLang,运行scripts目录下部署脚本,对外提供HTTP向量推理服务,适配线上业务调用。
5. 效果评测
运行mmeb_v3_eval目录脚本,可复现MMEB‑v2、MMEB‑v3全套评测结果,完成自定义数据集评测。
六、竞品对比
| 项目 | WeMM‑Embedding | VLM2Vec | CLIP‑ViT‑L‑14 |
|---|---|---|---|
| 开发方 | 腾讯微信视觉团队 | 通用开源项目 | OpenAI |
| 参数规模 | 2B/4B/9B | 多种VLM基座 | ViT‑L‑14 |
| 视频原生支持 | ✅原生支持视频输入编码 | 需要二次开发适配视频 | ❌不支持视频,仅图片 |
| 嵌套MRL向量降维 | ✅支持,多维度输出 | ❌不支持 | ❌不支持 |
| 图文交错混合输入 | ✅支持 | 部分支持 | ❌不支持 |
| 自带大规模评测基准 | ✅MMEB‑v2/v3完整开源 | 基础评测集 | 原始OpenAI评测集 |
| 推理服务脚本 | ✅vLLM/SGLang部署脚本 | 无官方部署脚本 | 无官方部署脚本 |
七、常见问题解答
Q:WeMM‑Embedding是否支持音频输入做向量嵌入?
A:不支持,该模型输入仅覆盖文本、图片、视频、视觉文档、图文交错内容,音频任务无法使用本模型处理。
Q:MRL嵌套向量截断之后,是否还需要重新归一化?
A:需要,截断向量维度之后,必须重新做L2归一化,才能保证相似度计算结果正确。
Q:2B模型性能表现怎么样,适合什么硬件?
A:2B版本综合表现优秀,在很多任务上超越8B级别基线模型,对显存要求低,适合中小显存显卡、私有化轻量部署场景。
Q:是否可以直接商用?
A:主体代码采用Apache‑2.0协议可以商用,项目内部分第三方组件保留原有许可证,商用前需要核对第三方组件版权声明。
Q:运行时报transformers版本相关报错如何处理?
A:项目推荐使用transformers==5.2.0,更换为该版本即可解决大部分兼容性报错。
Q:视频输入的时候,帧采样需要自己处理吗?
A:评测脚本已经内置64帧采样逻辑,开发者可直接参考官方示例,无需自己从零实现帧采样逻辑。
八、相关链接
GitHub项目仓库:https://github.com/Tencent/WeMM‑Embedding
Hugging Face模型地址:https://huggingface.co/collections/tencent/wemm-embedding
技术论文arXiv:https://arxiv.org/abs/2608.24053
九、总结
WeMM‑Embedding是腾讯微信视觉团队推出的一套完整开源多模态向量嵌入模型家族,覆盖2B、4B、9B不同参数档位,实现文本、图像、视频、视觉文档统一向量空间编码,具备嵌套向量降维能力,同时开放推理、高性能部署、大规模评测完整工程代码,为开发者构建多模态检索、多模态RAG、素材处理业务提供开箱即用的开源方案。
版权及免责申明:本文由@AI铺子原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/wemm-embedding.html