AI视频推理框架横向对比:本地跑视频模型,怎么选推理引擎
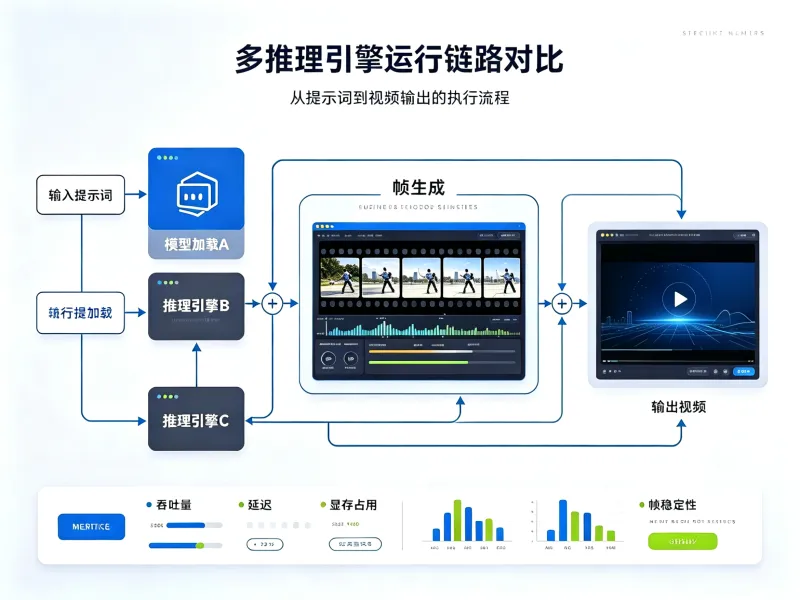
现在开源视频模型数量越来越多,很多AI爱好者下载权重之后,直接用原生框架跑推理,经常遇到显存爆掉、生成速度极慢的问题。
同样的视频模型,更换不同推理引擎,显存占用、生成速度差距会非常明显。
很多人只关注视频模型本身参数,忽略推理框架的选型,白白浪费显卡硬件资源。本文横向对比当下主流的本地AI视频推理框架,讲解各自优势、限制、适配场景,给出选型思路,帮助大家根据自己的显卡、使用需求挑选合适引擎。
一、什么是AI视频推理引擎
AI视频模型权重本身,只是存储参数文件,无法直接运行。
推理引擎相当于中间层,负责读取模型权重、拆分计算任务、调度显卡显存、完成逐帧图像生成。
不同引擎底层优化思路不一样,有的侧重显存压缩,有的侧重并行加速,有的侧重多硬件兼容。
简单理解:模型是“画师”,推理引擎就是“工作台”。
同一个画师,工作台好坏,直接决定作画速度、占用空间大小。工作台本身不会提升画师绘画水平,但能决定画师能不能在小空间内顺利工作。
二、主流本地AI视频推理框架横向对比
| 对比项目 | Byte轻量推理引擎 | ComfyUI Video | Diffusers原生推理 | vLLM视频分支 |
|---|---|---|---|---|
| 核心优化方向 | 显存压缩,帧间缓存复用 | 可视化工作流,插件生态 | 开箱易用,模型兼容性好 | 注意力计算加速 |
| 最低显存要求(4K视频) | 24G | 32G | 40G | 28G |
| GUI支持 | 需要开发者二次集成 | 自带可视化界面 | 代码调用为主 | 代码部署为主 |
| 适配模型范围 | 主流开源视频模型 | 绝大多数开源视频模型 | HuggingFace全系列模型 | 支持部分视频大模型 |
| 上手难度 | 高,面向开发者 | 低,可视化拖拽 | 中等,需要基础代码 | 高,适合技术玩家 |
| 优势亮点 | 显存优化效果突出 | 生态丰富,自定义工作流 | 模型适配广,上手简单 | 推理速度快 |
| 短板 | 缺少可视化操作界面,需要开发集成 | 高分辨率视频显存消耗偏高 | 显存开销大,4K很难本地跑 | 部分视频模型适配不完善 |
三、四类框架详细解读
1. Byte轻量推理引擎
刚刚发布的这套引擎,核心卖点就是显存优化,官方实测4K视频单卡24G显存即可运行。
它的核心技术是动态帧缓存复用,连续视频帧之间大量重复特征不需要重复计算,减少显存重复占用。
但它没有自带可视化操作界面,不能直接给普通用户使用。
只提供SDK,需要开发者集成到桌面客户端或者工具内。适合想要开发本地AI视频工具的开发者,普通个人创作者很难直接上手。
适合场景:二次开发、搭建本地视频生成服务,硬件显存有限,优先降低显存占用。
2. ComfyUI Video
这是目前普通AI玩家使用最多的视频推理方案。
可视化节点拖拽操作,不需要写代码,插件生态完善,网上现成工作流资源非常丰富。
支持图片转视频、文本生成视频、视频插帧等多种任务。
缺点是高分辨率视频对显存要求高,跑4K视频通常需要32G以上显存。
大量节点同时加载的时候,内存占用也会随之上涨,低配机器容易卡顿。
适合场景:个人创作者,不想写代码,需要灵活调整视频生成工作流,以1080P视频制作为主。
3. Diffusers原生推理
HuggingFace推出的原生推理库,最大优势就是模型兼容性强。
只要是HuggingFace平台发布的视频模型,基本都可以直接加载,适配速度最快。
上手门槛中等,简单修改几行代码,就能启动视频生成任务。
原生版本没有做深度显存优化,高分辨率视频推理显存开销巨大。
想要本地跑4K视频,通常需要40G以上显存,普通消费显卡很难承载。
适合场景:模型测试、快速验证新开源视频模型效果,以1080P及以下分辨率测试为主。
4. vLLM视频分支
vLLM原本是大语言模型推理引擎,后续扩展支持视频模型。
依靠PagedAttention技术,大幅加速注意力计算,推理生成速度是一大亮点。
短板在于视频模型适配范围有限,并不是所有开源视频模型都能直接兼容。
遇到不支持的模型,需要手动修改模型代码,调试成本较高。
适合场景:技术爱好者,优先追求视频生成速度,愿意花时间调试模型适配问题。
四、按用户身份与硬件选型建议
场景1:普通创作者,显卡24G显存,主要做1080P视频
优先选择ComfyUI Video。现成工作流多,可视化操作,社区教程充足。
如果想尝试4K视频,可以关注Byte轻量引擎对应的集成工具,等待第三方打包GUI客户端。
场景2:开发者,需要开发本地AI视频工具,显存资源紧张
优先考虑Byte轻量推理引擎。显存优化能力强,SDK可以集成进桌面程序,降低终端用户硬件门槛。
需要自行开发前端交互界面,搭配模型管理逻辑。
场景3:AI模型测试爱好者,经常体验各类新开源视频模型
优先Diffusers原生推理。新模型发布之后,基本第一时间就能加载测试,不需要等待引擎适配更新。
硬件充足前提下,用来验证模型效果非常方便。
场景4:技术玩家,追求视频生成速度,熟悉代码调试
优先vLLM视频分支。推理速度优势明显,但是要做好模型适配调试的准备。
五、实操避坑要点
第一,不要把推理引擎和生成模型混为一谈。引擎不改变视频生成画质,只能优化显存、速度。画质上限完全由视频模型权重决定。更换再好的推理引擎,也不能让低参数模型生成高清细节。
第二,显存标注为最低运行门槛,不代表稳定流畅。最低显存仅仅代表可以启动推理,生成长视频序列时,依旧可能出现显存溢出。实际使用建议预留20%左右显存余量。
第三,跨平台兼容性差异。很多推理引擎在Linux环境优化更好,Windows平台偶尔会出现驱动、CUDA版本兼容问题。部署前核对推荐CUDA版本。
第四,模型许可证需要单独留意。推理引擎本身开源免费,但你接入的视频模型,可能有商用限制,商用前核对模型License。
FAQ
Q:显存不够,优先换推理引擎还是降低视频分辨率?
优先降低分辨率。更换推理引擎只能做到一定程度显存缩减,存在上限。如果显存差距过大,更换引擎也无法正常运行。分辨率对显存消耗影响最大。
Q:ComfyUI可以接入Byte这套轻量推理引擎吗?
目前原生不支持。需要开发者开发自定义节点,完成引擎对接,社区暂时没有成熟的现成插件。
Q:云端API视频生成,需要关心推理引擎选型吗?
不需要。云端服务厂商内部已经完成引擎、硬件调度,用户只需要调用接口,底层推理框架对使用者透明。
Q:推理引擎加速之后,视频生成会消耗更多CPU资源吗?
部分显存优化策略会把部分计算转移到内存与CPU,极端情况下CPU占用会小幅上涨。正常显卡推理场景,CPU占用提升幅度有限。
总的来说,挑选AI视频推理引擎,核心看你的硬件显存、是否需要可视化操作、是做个人创作还是开发服务。普通创作者优先ComfyUI Video;开发者想要降低端侧显存门槛,可以关注字节新发布的轻量推理引擎。
版权及免责申明:本文由@AI工具箱原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-tutorial/ai-video-inference-framework-comparison.html