FireRedTTS3:小红书开源的多语言指令式语音生成与编辑TTS项目
FireRedTTS3是什么
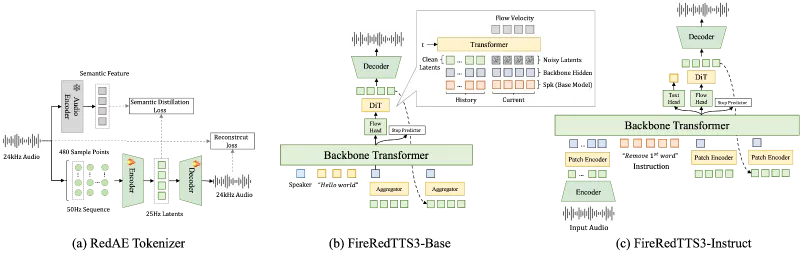
FireRedTTS3是小红书推出的开源PyTorch端到端语音生成项目,基于语义增强连续语音表征技术,分为Base、Instruct两大模型版本,采用Apache‑2.0开源协议。项目兼顾零样本音色克隆、自然语言驱动语音设计、音频语义与声学编辑能力,支持多国语言与国内大量方言,可本地部署运行,配套arXiv技术报告,是集语音合成、音色复刻、语音编辑于一体的完整开源TTS方案。
功能特色
零样本音色克隆:输入一小段参考音频,即可复刻说话人音色,支持跨语言、跨方言合成语音,无需微调模型。
自然语言语音设计:Instruct版本支持无参考音频,直接用文字描述性别、年龄、情绪、口音、语速,生成全新定制音色。
语义语音编辑:在保留原有说话人音色不变的前提下,对已有音频做文本替换、内容插入、内容删除,修改音频说话内容。
声学属性编辑:针对已有音频调整音高、语速、音量等声学参数,声学指令需要遵循项目指定模板格式。
强大多语言方言能力:覆盖24门主流语种,同时内置21种中文方言,包含四川话、上海话、闽南话等,适配国内本地化语音需求。
本地可完整运行:支持Python API调用,提供完整推理脚本,可选择本地文本归一化工具,也可接入兼容OpenAI格式的API完成多语种文本预处理。
技术细节
模型分支
FireRedTTS3‑Base:侧重零样本音色克隆,面向批量语音合成、音色复刻场景。
FireRedTTS3‑Instruct:指令一体化模型,同时具备克隆、语音设计、语义编辑、声学编辑全套能力。
核心底层组件
基于Qwen3大模型、X‑Codec音频编解码器、CAM++说话人表征模型构建;可选fastText实现自动语种识别;文本归一化提供两套方案:wetext本地工具仅支持中英;LLM‑TN通过OpenAI兼容API实现全语种文本标准化。表征方案:采用语义增强连续语音表征,打通文本、音色参考音频、编辑指令三者之间的映射,实现合成与编辑任务统一模型。
评测指标
在Seed‑TTS‑eval零样本克隆测试集,Base版本WER/CER为3.04%,说话人相似度78.8%;MiniMax‑MLS‑Test多语言测试集,平均说话人相似度可达84.8%;在语音编辑任务上,对比同类开源编辑模型,在编辑准确率、音色保留、生成音质上具备优势。运行依赖:基于PyTorch框架,预训练权重通过Hugging Face Hub分发,环境配置支持GPU推理。
应用场景
本地化AI语音制作:短视频配音、有声读物、播客内容批量生成,可复刻特定音色,也可自定义全新音色。
方言语音生成:文旅内容、方言科普、地方短视频,生成四川话、上海话等方言音频。
音频后期编辑:已有录音片段修改台词,不用重新录制,保留原说话人音色,用于短剧音频、课件音频二次修改。
多语种内容产出:跨境内容配音,同时支持多语种混合生成语音。
技术二次开发:开发者二次封装,搭建私有语音接口,部署本地私有化语音服务,不依赖第三方在线TTS接口。
使用方法
环境准备
克隆项目仓库,安装项目依赖pip install -r requirements.txt;从Hugging Face Hub下载对应预训练权重存放至本地。文本归一化配置
中英场景:使用wetext本地工具完成文本归一化;
多语种场景:配置
.env文件,填入OpenAI兼容API地址与密钥,启用LLM‑TN文本归一化。
可选语种识别
下载fastText lid.176模型文件,开启自动语种识别功能。调用推理
项目提供四类Python API接口:Base音色克隆接口、Instruct语音设计接口、Instruct语义编辑接口、Instruct声学编辑接口;调用接口传入参数,直接输出wav格式音频文件。
竞品对比
| 项目名称 | 核心优势 | 主要短板 | 模型特点 |
|---|---|---|---|
| FireRedTTS3 | 支持21种中文方言;同时支持语音合成、音色克隆、语义+声学编辑;支持无参考音频语音设计;提供Base与Instruct双版本 | 声学编辑需要遵循固定指令模板;多语种预处理依赖外部LLM‑TN | PyTorch,双模型分支,Apache‑2.0协议 |
| Qwen3‑TTS‑VD | 阿里开源,生态完善,推理速度优秀,中文合成效果好 | 方言覆盖数量偏少,缺少完整音频语义编辑能力 | 单模型侧重合成与克隆,支持指令,Apache‑2.0协议 |
| Ming‑UniAudio‑Edit | 强大的音频编辑能力,支持多种音频修改任务 | 方言支持弱,零样本跨语种克隆表现一般,语音设计能力缺失 | 偏向音频编辑,侧重已有音频修改 |
常见问题解答
Q:FireRedTTS3‑Base和FireRedTTS3‑Instruct应该怎么选?
A:如果仅做音色克隆、语音合成,优先选择Base版本;如果需要语音设计、语义编辑、声学编辑功能,则使用Instruct版本。
Q:为什么多语种场景下wetext工具无法正常工作?
A:wetext仅支持中文、英文文本归一化,其他语种需要配置LLM‑TN,使用OpenAI兼容API完成文本预处理。
Q:声学编辑指令可以随意写自然语言吗?
A:不可以,声学编辑需要严格遵循项目给定的指令模板,自由句式会导致编辑效果异常、生成音频出错。
Q:可以完全脱离网络本地离线运行全部功能吗?
A:音色克隆、中英合成可以完全离线;全语种文本归一化LLM‑TN功能需要调用外部API,无法离线。fastText语种识别下载模型后可以离线使用。
Q:生成出来音频音色和参考音频差距很大是什么原因?
A:参考音频尽量保证音质清晰,无大量背景噪音;同时确认使用对应版本模型权重,检查参考音频采样率是否匹配项目要求。
Q:项目协议是Apache‑2.0,是否可以用于商业项目?
A:遵循Apache‑2.0开源协议规范,按照协议要求使用即可,具体需要自行阅读协议文档。
相关链接
arXiv技术报告:https://arxiv.org/abs/2608.17492
Hugging Face仓库:https://huggingface.co/FireRedTeam/FireRedTTS3
总结
FireRedTTS3是一套功能完备的开源语音生成与编辑项目,兼顾零样本音色克隆、自定义语音设计、音频多维度编辑,在中文方言、多语言方面有突出表现,提供两套模型适配不同业务需求,本地部署方案完整,为开发者、内容创作者提供了私有化的TTS技术方案。
版权及免责申明:本文由@AI工具集原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/fireredtts3.html