
HeyGen Voice:HeyGen自研的AI语音大模型
HeyGen Voice是HeyGen自研AI语音大模型,支持文本转语音、即时/专业语音克隆,原生配套数字人Avatar,实现语音与口型精准同步,可独立导出音频或生成数字人视频,附带API接...
HeyGen Voice是HeyGen自研AI语音大模型,支持文本转语音、即时/专业语音克隆,原生配套数字人Avatar,实现语音与口型精准同步,可独立导出音频或生成数字人视频,附带API接...
FireRedAudio是小红书开源发布的通用音频语言大模型,基于9B参数主干模型,采用解耦连续表征架构,单模型同时实现音频理解、语音生成、语音编辑三大类能力。
Breeze TTS 2是国内AI语音企业BreezeBlue发布的新一代TTS语音合成模型。它专门面向实时人机交互场景,将语音设计、角色演绎、低延迟流式生成整合为一体化模型,不再局限传统...
FireRedTTS3是小红书推出的开源PyTorch端到端语音生成项目,基于语义增强连续语音表征技术,分为Base、Instruct两大模型版本,采用Apache‑2.0开源协议。项目兼顾零样本音色...
Luna‑TTS是VUI Labs(宇生月伴)研发的扩散‑语言模型架构的文本转语音(TTS)项目,整套家族包含Luna‑TTS全并行版本、Luna‑TTS Realtime实时流式两个子模型,主干网络参...

Vocalove是网页端AI声音克隆工具,仅需3~30秒音频样本即可复刻人声,免安装浏览器直接使用,支持内置TTS音色,可生成纯音频或者会说话人像纪念视频,免费预览,一次性点数...
MAI-Voice-2-Flash是微软于2026年7月官方发布、基于自研MAI语音基座训练的极速低延迟文本转语音(TTS)模型,隶属于微软MAI语音模型家族,依托Azure AI Foundry与Azure语音...
Qwen-Audio-3.0-TTS 是阿里巴巴 Token Foundry 团队研发的工业化高质量语音合成模型,归属通义千问音频系列。模型面向真实生产场景打造,主打高保真音色克隆、多语种与汉语...
Confucius4-TTS是网易有道推出基于LLM架构的开源跨语种零样本语音合成引擎,支持14种语言免参考文本音色克隆、无口音跨语种语音迁移、音频情感同步复刻,提供在线Gradio演示...
VoiceCanvas是网页端一站式AI TTS平台,支持50+语种文本转语音、10秒人声克隆、AI自定义音色、故事多角色配音与自动播客生成,免费试用,支持微信支付宝,适配自媒体、教育...
OmniVoice Studio 是一个完全开源、本地运行的 AI 语音工具集,定位为 ElevenLabs 的替代品。它支持 646 种语言的零样本语音克隆、语音设计(多参数调节)、全流程视频配音...
Inworld Realtime TTS-2 是由 Inworld AI 官方推出的第二代实时语音合成模型,专为真人实时多轮对话场景深度定制,区别于传统面向有声书、旁白播报的通用TTS产品。
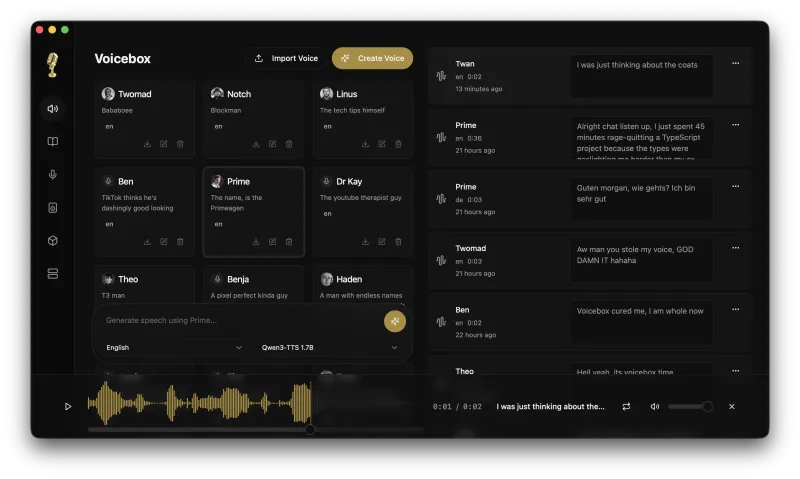
Voicebox是一款开源本地优先AI语音合成工具,主打隐私安全、全功能语音创作与跨平台高性能运行。作为免费的 ElevenLabs 开源替代方案,它支持零样本语音克隆、7款TTS引擎、...
OmniVoice是k2-fsa团队(小米Kaldi团队)开源的超大规模多语言零样本文本转语音(TTS)系统,基于创新单阶段离散非自回归扩散语言模型架构,支持646种语言的高质量语音生成...
LongCat-AudioDiT是美团LongCat开源的基于扩散模型的高保真文本转语音(TTS)与零样本语音克隆模型,是当前语音合成领域的SOTA(State-of-the-Art)方案之一。该模型彻底革...