FreeToken:消费级硬件运行大MoE模型的开源推理框架
FreeToken是什么
FreeToken 是由 FlashML‑org 开源、基于 Apache‑2.0 开源协议发布的边缘原生MoE(混合专家)大模型推理服务引擎,该项目核心目标,让消费级普通PC、笔记本、工作站这类边缘硬件,能够本地运行数百B参数规模的MoE大模型。它把GPU显存、CPU内存、主机内存、硬件互联链路整合为统一弹性资源池,解决传统推理框架运行大MoE模型显存占用高、硬件门槛高、上下文重复计算损耗大的痛点,同时对外提供兼容主流大模型服务的API接口,可对接各类AI Agent、本地知识库、代码助手应用。
项目主要开发语言为Python,搭配CUDA、C++高性能内核实现底层加速,适配RTX30/40/50系列消费级NVIDIA显卡,同时支持A100/A800等专业计算显卡。
功能特色
带宽自适应MoE推理调度:采用q⋆调度策略,搭配全层双缓冲预取流,根据硬件实际带宽自动调节专家加载逻辑,弱化MoE模型对超大显存的硬性要求。
全局LRU专家缓存机制:对MoE专家权重做缓存管理,减少权重反复加载释放带来的IO开销,提升连续对话吞吐量。
语义感知KV缓存快照:针对Agent工具调用、思维链改写场景做语义锚点快照,上下文局部修改时,避免全部KV缓存重新计算,降低算力消耗。
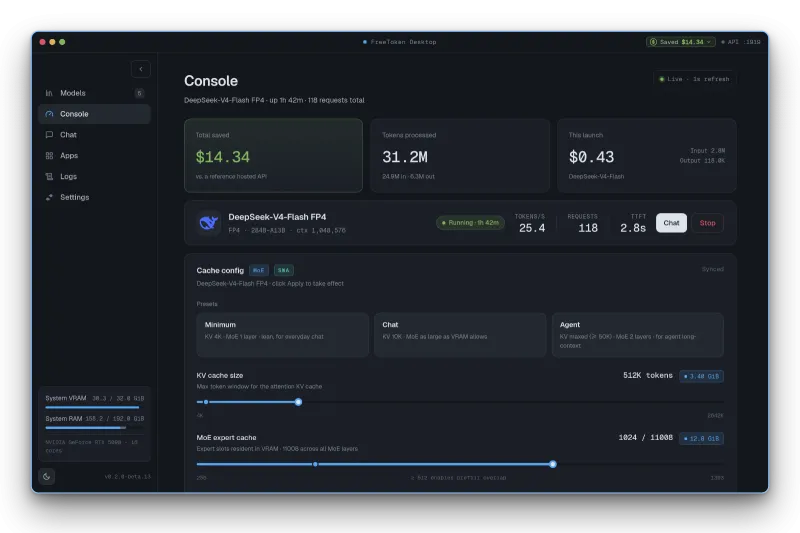
动态显存资源重分配:运行状态下可动态调整专家缓存与KV缓存的显存占比,不需要重启推理服务、不需要重新加载模型权重,灵活适配长文本、多并发不同业务。
多量化格式原生支持:兼容MXFP4、NVFP4、FP8、BF16多种主流量化格式,适配不同精度‑性能取舍需求。
标准化对外API:兼容OpenAI、Anthropic接口协议,现有基于OpenAI接口开发的应用几乎无需改造即可接入。
双形态部署模式:提供可视化GUI桌面客户端,同时提供CLI命令行部署模式,兼顾普通用户与开发者。
多MoE模型兼容:原生支持DeepSeek‑V4‑Flash、Qwen3.6‑35B‑A3B、GLM‑5.2等主流开源MoE大模型。
技术细节
FTW高速权重格式:项目自研FTW权重存储格式,针对MoE专家权重分片做优化,加快权重加载、分片读取速度,同时增加异常校验,分片损坏时主动抛出异常,规避静默出错。
q⋆带宽自适应调度策略:不采用固定专家驻留策略,实时采集CPU‑GPU之间带宽指标,动态决定哪些专家常驻显存、哪些专家按需从内存加载,平衡延迟与显存占用,是实现消费硬件跑大MoE的核心算法。
双缓冲预取流:分层预取MoE专家权重,推理计算和权重数据搬运并行执行,掩盖磁盘、内存到GPU的数据传输延迟。
语义锚点KV缓存快照:区别传统按token位置保存KV缓存,使用语义锚点标记上下文片段。当Agent修改局部上下文、调用工具返回结果插入对话时,只重新计算变更片段,保留未改动部分KV缓存,大幅减少重复计算。
运行时显存动态切分:推理进程运行期间,在专家权重缓存池、KV缓存池之间动态划拨显存资源。长文本场景扩充KV缓存;多轮高频专家切换场景扩充专家缓存,无需重启服务。
GPU硬件适配内核:CUDA内核针对消费卡RTX30/40/50系列做专门调优,同时兼容A100/A800计算卡sm_80架构;底层实现参考借鉴SGLang、vLLM、FlashInfer、llama.cpp等开源项目。
应用场景
本地私有大模型部署:个人开发者、工作室在消费级电脑本地部署200B+级别MoE模型,数据不出本机,保障隐私,不需要租用昂贵云端GPU。
AI Agent本地运行:本地代码Agent、工具调用智能体,频繁修改对话上下文场景,借助语义KV快照减少重复推理开销。
边缘工作站离线推理:无公网环境的工作站,离线运行大型MoE模型,用于文档解析、本地知识库问答。
二次开发与研究实验:MoE大模型推理算法研究,自定义调度策略、缓存策略二次开发。
兼容OpenAI生态工具:现有基于OpenAI接口的应用,直接对接FreeToken服务,替换云端MoE模型为本地硬件。
使用方法
方式一:GUI桌面客户端(Windows / Linux)
前往官方站点 flashml.ai 下载一键客户端,图形界面完成模型导入、参数配置、对话调试,开箱即用,适合普通用户。
方式二:CLI源码/包安装部署
使用uv或者pip安装完整依赖包:
pip install freetoken[accel]也可以直接克隆GitHub源码仓库,本地编译CUDA内核,完成环境构建。
启动推理服务,服务对外暴露兼容OpenAI的API接口,即可接入对话、Agent业务。
硬件前提:NVIDIA显卡,CUDA环境,推荐RTX40系及以上消费显卡体验。
竞品对比
选取 vLLM、SGLang 两个主流推理框架做对比。
| 对比维度 | FreeToken | vLLM | SGLang |
|---|---|---|---|
| 核心定位 | 面向边缘消费硬件的MoE专用推理引擎 | 通用大模型推理服务框架 | 高性能通用推理服务框架 |
| MoE调度策略 | q⋆带宽自适应调度+LRU专家缓存 | 固定专家驻留,PagedAttention | 专家预取,侧重服务器GPU优化 |
| 特色缓存能力 | 语义感知KV快照,运行时动态显存重分配 | PagedAttention分页KV缓存 | RadixCache树状KV缓存 |
| 消费级显卡优化 | 原生针对RTX30‑50系列调优 | 优先面向服务器GPU,消费卡兼容 | 优先面向服务器GPU,消费卡兼容 |
| 关键优势 | 降低大MoE硬件门槛,无需重启动态调显存 | 生态成熟,社区庞大,模型覆盖广 | 高吞吐,适合大规模云端部署 |
| API兼容 | OpenAI、Anthropic协议 | OpenAI协议 | OpenAI协议 |
常见问题解答
Q:FreeToken 只能运行MoE模型吗?
A:项目设计重心针对MoE混合专家模型做深度优化,重点解决大MoE在边缘硬件的运行难题;普通稠密大模型也可以运行,但不会发挥全部的专属优化特性。
Q:没有NVIDIA显卡可以运行FreeToken吗?
A:底层大量CUDA加速内核依赖NVIDIA显卡,目前主要支持NVIDIA GPU;无N卡环境无法完整使用加速能力,不推荐使用。
Q:普通家用显卡,能够跑多大参数的MoE模型?
A:取决于显卡显存大小、内存容量,项目依靠内存‑GPU协同调度,可运行远超物理显存大小的MoE模型,但显存不足时推理延迟会上升。
Q:FTW权重格式是什么,必须转换模型权重吗?
A:FTW是项目自研高速权重分片格式,用于加速MoE专家读写;原生建议转换为FTW格式使用,也支持部分原生权重格式加载。
Q:FreeToken可以直接对接LangChain、LlamaIndex吗?
A:可以,因为对外提供标准OpenAI兼容API,LangChain、LlamaIndex等框架直接配置对应接口地址即可接入,不需要额外改造代码。
Q:商业项目里面是否可以直接使用FreeToken?
A:项目使用Apache‑2.0开源协议,允许商业使用,需要遵守协议的版权声明要求。
相关链接
官方网站:flashml.ai
总结
FreeToken作为专门面向边缘硬件打造的MoE推理开源引擎,通过带宽自适应调度、语义KV缓存、运行时动态显存分配等一系列技术,打破了大参数MoE模型对高端服务器GPU的依赖,让普通消费级PC、工作站具备本地运行数百B规模MoE模型的能力,同时兼容主流API生态,对于重视本地私有化部署、做MoE推理研究、本地Agent开发的开发者来说,是一个具备实际落地价值的开源工具。
版权及免责申明:本文由@AI铺子原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-news/freetoken.html