AuK:腾讯混元推出的统一指令式语音基础模型
一、AuK是什么
AuK 是腾讯混元团队开源的1.5B参数语音基础模型,采用MIT开源协议。它最大的特点是使用自然语言统一指令接口,把语音合成、语音编辑、语音增强、声源分离等多种语音任务整合到同一个模型体系中,无需针对不同任务单独部署多个模型。
项目提供两个模型版本:AuK‑Base基础版、AuK‑Flash蒸馏加速版。模型推理依赖外部多模态编码器 Qwen2.5‑Omni‑3B,权重可在 HuggingFace、ModelScope 获取,配套提供推理代码、本地WebUI、ComfyUI节点以及轻量微调脚本。
二、功能特色
AuK依靠自然语言指令驱动全部语音能力,无需切换模型,覆盖五大语音任务:
语音生成:零样本TTS,上传参考音频复刻音色生成文本语音;指令式TTS,仅用文字描述音色、情绪,无需参考音频直接生成语音。
语音内容编辑:对已有录音做文本替换、插入、删除;修改演唱录音歌词,保留原有旋律与人声。
声学属性编辑:自由调整音频音调、语速、音量。
副语言信息编辑:修改说话人情绪、音色,消除口音;增加或删除呼吸声、笑声、咳嗽等非语音信号;语音与耳语互转,保持说话人和文本内容不变。
语音增强与声源分离:音频降噪、去混响修复;说话人分离;从伴奏中提取人声;根据文本提取目标说话人音频。
配套辅助工具:Prompt Enhancer,可将普通人的自然口语请求自动转换成模型可识别的指令;提供Gradio网页Demo、CLI命令行、Python API、ComfyUI节点多种调用入口,同时支持轻量自定义微调。
三、技术细节
模型参数:主体AuK模型1.5B参数,分为Base与Flash两个版本
AuK‑Base:侧重语音生成质量,可自定义推理步数NFE与CFG参数。
AuK‑Flash:蒸馏优化版本,固定4步推理,CFG=0,主打低延迟推理。
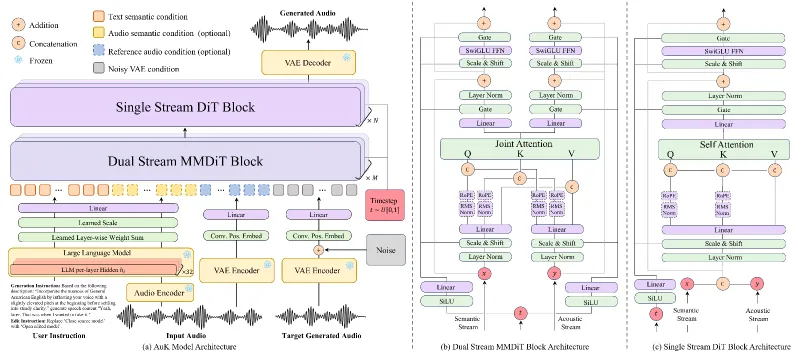
架构特点:采用统一指令范式,所有语音任务使用相同模型权重,依靠文本指令区分任务类型,不再为TTS、降噪、语音分离单独训练独立模型。
外部依赖:推理必须搭配Qwen2.5‑Omni‑3B作为文本+音频编码器,Qwen3‑Omni暂不支持。加载权重出现
text_encoder.*相关缺失属于正常现象,编码器独立加载。运行环境:推荐Python3.10,支持uv、conda环境管理;ComfyUI集成版本存在30秒音频序列上限。
微调方案:轻量微调,训练数据采用JSONL格式,每条样本由用户指令音频与目标音频成对组成,支持全部任务方向微调。
四、应用场景
内容创作:短视频配音、歌曲歌词修改、角色语音生成,复刻指定音色。
音频后期:录音降噪、去除混响,调整语速情绪,删减录音冗余语句。
播客/有声书:耳语旁白制作,调整朗读情绪,分离多人对话音频。
音频产品开发:本地语音编辑工具、实时语音修复、音色复刻能力二次开发。
研究学习:语音大模型实验、指令式语音模型微调、多任务语音算法研究。
五、使用方法
环境准备:安装Python3.10,拉取GitHub仓库,安装项目依赖;下载AuK模型权重与Qwen2.5‑Omni‑3B编码器权重。
调用方式
CLI命令行:使用
auk-infer命令,传入指令、输入音频文件、输出路径完成推理。Gradio WebUI:启动本地网页界面,可视化上传音频、填写指令,切换Base/Flash模型。Prompt Enhancer需要接入兼容OpenAI协议的LLM接口,ASR可选用腾讯云接口或本地SenseVoiceSmall备选。
Python API:实例化
AukInfer类,构造文本+音频消息列表,调用接口生成音频。ComfyUI:导入项目提供的auk.json工作流,加载自定义节点,在可视化工作流内完成语音生成编辑。
微调:准备JSONL格式训练数据集,运行项目内置微调脚本,针对自有场景做模型微调。
六、竞品对比
| 项目 | 开发方 | 核心特点 | 任务模式 | 开源权重 |
|---|---|---|---|---|
| AuK | 腾讯混元 | 1.5B单模型,自然语言指令统一处理TTS、语音编辑、降噪、声源分离,支持微调 | 统一指令驱动,单模型多任务 | ✅ MIT协议 |
| Parler-TTS | HuggingFace社区 | 专注文本描述生成语音,擅长音色描述TTS,不支持音频编辑、声源分离 | 单一任务模型 | ✅ |
| Fish Speech | Fish Audio | 侧重音色复刻TTS,支持长文本合成,音频编辑能力有限 | 以TTS为主,配套少量音频处理 | ✅ |
七、常见问题解答
Q:加载AuK权重时报text_encoder相关文件缺失,是权重损坏吗?
A:不是损坏。AuK主体模型不包含文本编码器,编码器需要独立加载Qwen2.5‑Omni‑3B,该缺失提示属于预期现象。
Q:AuK‑Flash相比AuK‑Base有什么取舍?
A:Flash版本经过蒸馏,固定4步推理、CFG=0,推理速度更快;牺牲部分音频细节与指令自由度,Base版本可以自由调节NFE、CFG参数,音频质量上限更高。
Q:ComfyUI插件使用时有音频长度限制吗?
A:有,ComfyUI集成版本最大支持30秒音频序列,超过时长会报错。
Q:Prompt Enhancer必须使用吗?
A:非必需。Prompt Enhancer作用是把口语化描述转成模型规范指令,如果你可以直接写模型可识别指令,不接入这个LLM接口也能正常推理。
Q:支持使用Qwen3‑Omni作为编码器吗?
A:目前不支持,官方仅推荐Qwen2.5‑Omni‑3B。
八、相关链接
项目官网:https://auk-project.github.io/
GitHub仓库:https://github.com/Tencent-Hunyuan/AuK
HuggingFace模型库:https://huggingface.co/tencent/AuK
arXiv技术论文:https://arxiv.org/pdf/2609.08936
九、总结
AuK由腾讯混元团队开源,以1.5B参数单模型实现自然语言指令驱动下的多类型语音任务,打破传统语音系统需要多个独立模型分别处理合成、编辑、增强、声源分离的模式,提供网页、命令行、ComfyUI、Python API等多种部署方式,开放轻量微调能力,MIT协议允许商用二次开发,为音频内容创作者、开发者、语音算法研究者提供了一套一体化本地语音处理方案。
版权及免责申明:本文由@dotaai原创发布。该文章观点仅代表作者本人,不代表本站立场。本站不承担任何相关法律责任。
如若转载,请注明出处:https://www.aipuzi.cn/ai-newsauk.html